Cómo crear un selector de acciones con IA en Python que puedas auditar
PythonAILLMStock AnalysisStock Screener
Todos los selectores de acciones con IA te prometen la próxima NVIDIA.
Ninguno te enseña por qué.
Te dan una nota del 1 al 10, una etiqueta verde y un "Comprar". Lo que no te dan son los datos que hay detrás, los pesos del modelo ni una forma de comprobar si simplemente está persiguiendo lo que más subió el último trimestre.
Si:
pagas por un AI stock picker y te preguntas qué lleva dentro,
eres desarrollador y estás construyendo un producto fintech,
o eres un inversor con curiosidad cuantitativa que prefiere reglas a corazonadas,
Esto te interesa.
TL;DR
Un selector de acciones con IA tiene tres capas: datos limpios, un modelo de puntuación y una capa que explica el resultado. Solo los datos son difíciles.
He construido uno en unas 160 líneas de Python con EODHD APIs (Screener, Fundamentals, precios EOD y News Sentiment) y ChatGPT.
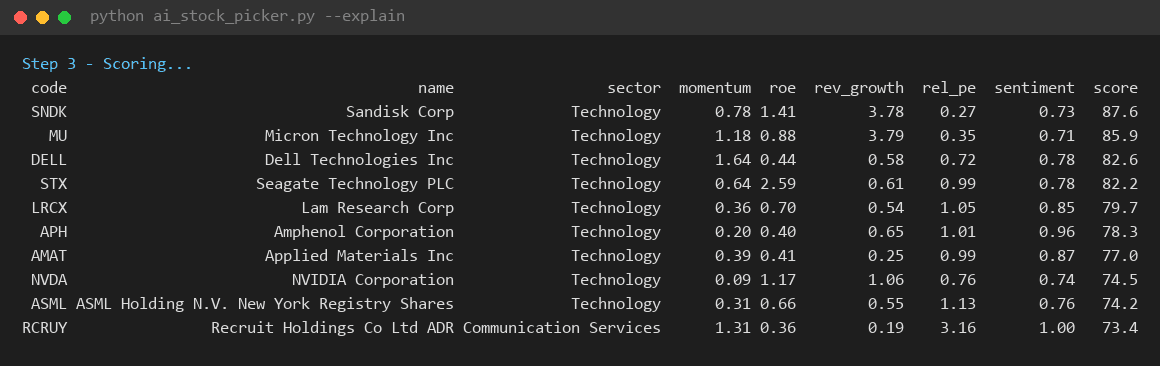
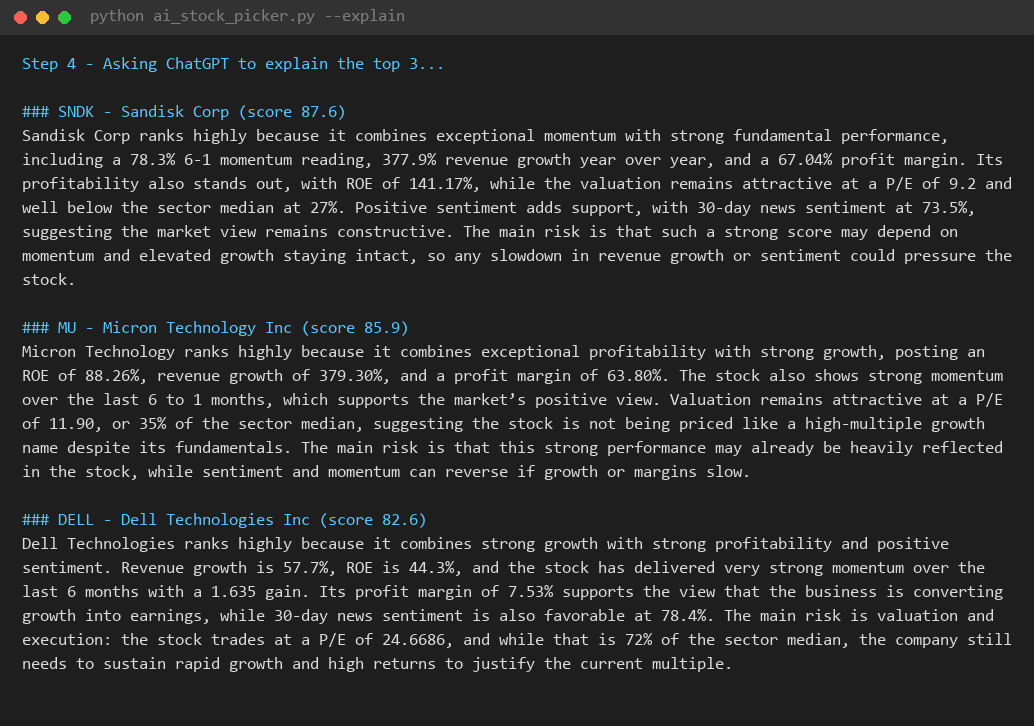
Ha ordenado 194 empresas grandes de EE. UU. por momentum, calidad, crecimiento, valor y sentimiento. SanDisk (87,6), Micron (85,9) y Dell (82,6) quedaron arriba el 1 de noviembre de 2026.
El LLM nunca elige acciones. Solo explica las elecciones con los números que le pasamos, así que no puede inventarse ratios.
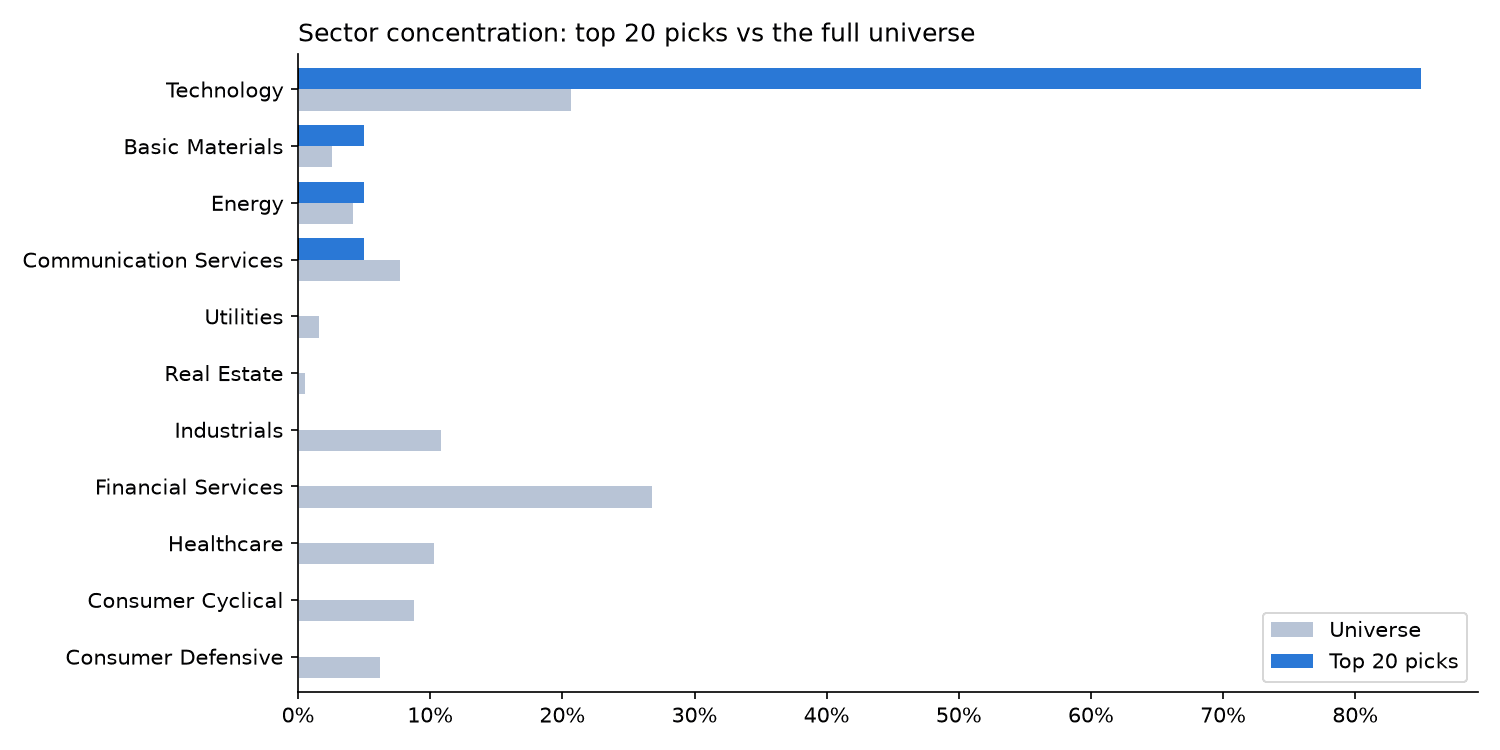
La lección más importante salió del propio resultado: 17 de las 20 primeras eran tecnológicas. Un modelo transparente te lo enseña. Una caja negra, no.
Por qué casi todos los AI stock pickers son cajas negras
Las apps más conocidas funcionan igual. Danelfin, Kavout y Prospero.ai cogen miles de acciones, las pasan por un modelo propietario y te devuelven un ranking.
Es útil. Pero tiene límites:
No ves los pesos. ¿La nota es un 80 % momentum? Nunca lo sabrás.
No puedes cambiar el universo. ¿Solo empresas que pagan dividendo, o solo europeas? Mala suerte.
"Gratis" suele significar "a medias". Los planes gratuitos suelen esconder las acciones mejor puntuadas detrás de un muro de pago.
La alternativa que casi todo el mundo prueba después es peor: abrir ChatGPT y preguntar "¿cuáles son las mejores acciones para comprar ahora?"
El modelo responde con total seguridad. A veces los PER que cita son de 2023. A veces, inventados.
Ninguna de las dos opciones te da un sistema que puedas auditar.
Qué es realmente un selector de acciones con IA
Artículos relacionados
Quita el marketing y cualquier AI stock picker hace tres cosas:
Recoge datos de un universo de acciones (precios, fundamentales, noticias).
Puntúa cada acción con un modelo, desde un ranking de factores sencillo hasta un gradient boosting.
Explica el resultado de forma que una persona pueda actuar.
Todo el mundo habla del modelo. Lo que se rompe son los datos.
Elegir acciones no necesita más inteligencia. Necesita mejores datos de entrada.
Los mejores AI stock pickers frente a construir el tuyo
Antes de escribir código, conviene ser honesto con lo que ganas y lo que pierdes.
Para quién es cada uno: si quieres una app lista para usar, elige una de las tres primeras. Si quieres saber exactamente por qué una acción sale la número 1, y poder cambiarlo, constrúyelo tú.
Es lo que vamos a hacer.
La capa de datos: EODHD APIs
Uso EODHD APIs para este tipo de proyectos porque con una sola API key tengo todo lo que necesita el selector:
Stock Screener API para construir el universo (filtrar por capitalización, bolsa o sector).
Fundamentals API para ROE, crecimiento de ingresos, márgenes y PER.
Y una pequeña función para llamar a cualquier endpoint de EODHD:
import os, json
from datetime import date, timedelta

import requests
import pandas as pd
from dotenv import load_dotenv

load_dotenv(override=True)
EODHD_KEY = os.environ["EODHD_API_KEY"]
BASE = "https://eodhd.com/api"


def get(path, **params):
    params.update(api_token=EODHD_KEY, fmt="json")
    r = requests.get(f"{BASE}/{path}", params=params, timeout=30)
    r.raise_for_status()
    return r.json()
Paso 1: Construye el universo de acciones con la Screener API
Empezamos con las 200 mayores empresas de EE. UU. con más de 10.000 millones de dólares de capitalización. La Screener API devuelve hasta 100 filas por llamada, así que paginamos.
Paso 2: Añade fundamentales, momentum y sentimiento de noticias
Cinco variables por acción. Cada una corresponde a un factor clásico:
Variable
Factor
Fuente
ROE (TTM)
Calidad
Fundamentals API
Crecimiento de ingresos interanual
Crecimiento
Fundamentals API
PER frente a la mediana del sector
Valor
Fundamentals API
Rentabilidad 6-1 meses
Momentum
EOD API
Sentimiento de noticias a 30 días
Sentimiento
Sentiment API
def fundamentals(ticker):
    h = get(f"fundamentals/{ticker}.US", filter="Highlights")
    return {
        "roe": h.get("ReturnOnEquityTTM"),
        "rev_growth": h.get("QuarterlyRevenueGrowthYOY"),
        "margin": h.get("ProfitMargin"),
        "pe": h.get("PERatio"),
    }


def momentum(ticker):
    """6-month return, skipping the most recent month (classic 6-1 momentum)."""
    start = (date.today() - timedelta(days=200)).isoformat()
    px = pd.DataFrame(get(f"eod/{ticker}.US", **{"from": start}))["adjusted_close"]
    if len(px) < 130:
        return None
    return px.iloc[-22] / px.iloc[-130] - 1


def sentiment(tickers):
    """Average news sentiment over the last 30 days."""
    start = (date.today() - timedelta(days=30)).isoformat()
    out = {}
    for i in range(0, len(tickers), 20):
        batch = [f"{t}.US" for t in tickers[i:i + 20]]
        data = get("sentiments", s=",".join(batch), **{"from": start})
        for sym, days in data.items():
            if days:
                out[sym.split(".")[0]] = sum(d["normalized"] for d in days) / len(days)
    return out
¿Por qué saltarse el último mes en el momentum? Porque los movimientos a muy corto plazo tienden a revertirse. La ventana 6-1 es la forma estándar de captar la tendencia sin ese ruido.
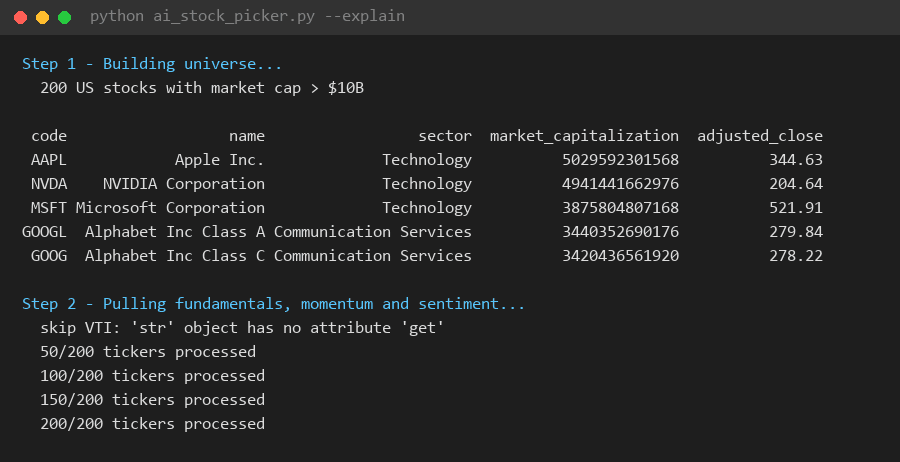
Esta es la salida real de los pasos 1 y 2:
Falló un ticker: VTI. Es un ETF, así que no tiene fundamentales de empresa. El try/except lo saltó y la ejecución siguió con 199 acciones.
Paso 3: Puntúa cada acción
Aquí no hay red neuronal. Cada variable se convierte en un percentil (de 0 a 1) y se multiplica por un peso. La suma da una nota de 0 a 100.
WEIGHTS = {"momentum": 0.25, "quality": 0.25, "growth": 0.20, "value": 0.15, "sentiment": 0.15}


def score(df):
    df = df[df["pe"].fillna(0) > 0].copy()  # drop loss-makers and missing P/E
    df["rel_pe"] = df["pe"] / df.groupby("sector")["pe"].transform("median")

    ranks = pd.DataFrame({
        "momentum": df["momentum"].rank(pct=True),
        "quality": df["roe"].rank(pct=True),
        "growth": df["rev_growth"].rank(pct=True),
        "value": (-df["rel_pe"]).rank(pct=True),
        "sentiment": df["sentiment"].rank(pct=True),
    }).fillna(0.5)

    for f, w in WEIGHTS.items():
        df[f"s_{f}"] = ranks[f] * w * 100
    df["score"] = df[[f"s_{f}" for f in WEIGHTS]].sum(axis=1).round(1)
    return df.sort_values("score", ascending=False).reset_index(drop=True)
Aquí hay dos decisiones de diseño importantes:
El valor es relativo al sector. Un PER de 25 es barato para una empresa de chips y caro para un banco.
Los datos que faltan reciben un 0,5 neutro. Una acción no sale castigada ni premiada por un hueco en los datos.
Este es el resultado. 194 acciones pasaron el filtro de PER:
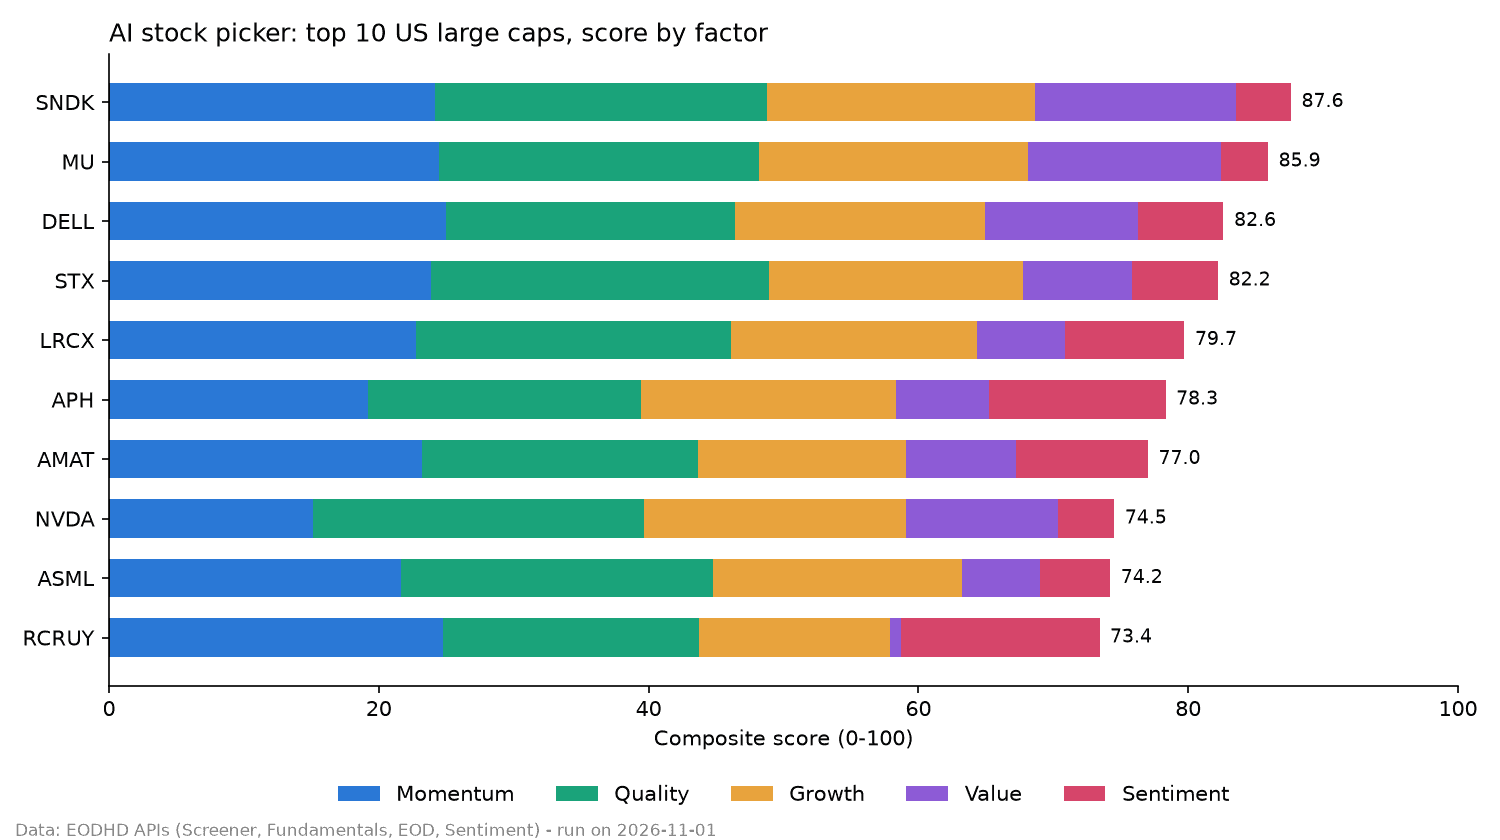
Y el mismo ranking en un gráfico, para ver qué factor empuja cada nota:
SanDisk y Micron llegan arriba siendo fuertes en todos los factores. Recruit Holdings (RCRUY) es el caso contrario: momentum y sentimiento de primera, pero casi nada en valor. Su PER es 3,16 veces la mediana de su sector.
Eso es justo lo que nunca ves con una nota única.
Paso 4: Que el LLM explique, no que elija
Aquí es donde fallan casi todos los tutoriales de "AI stock picker": le piden al LLM que elija las acciones.
Nosotros hacemos lo contrario. El modelo ya ha elegido. ChatGPT solo recibe los números de una acción y escribe la tesis.
from openai import OpenAI


def explain(row):
    facts = {
        "ticker": row["code"], "name": row["name"], "sector": row["sector"],
        "score": row["score"],
        "momentum_6_1": round(row["momentum"], 3),
        "roe_ttm": row["roe"], "revenue_growth_yoy": row["rev_growth"],
        "profit_margin": row["margin"], "pe": row["pe"],
        "pe_vs_sector_median": round(row["rel_pe"], 2),
        "news_sentiment_30d": round(row["sentiment"], 3) if pd.notna(row["sentiment"]) else None,
    }
    prompt = (
        "You are an equity analyst. Using ONLY the data below, write a 4-sentence "
        "investment thesis: why the model ranks this stock highly, and the main risk. "
        "Do not use any number that is not in the data. Ratios are decimals "
        "(0.25 = 25%): write them as percentages.\n\n" + json.dumps(facts, indent=2)
    )
    resp = OpenAI().responses.create(model="gpt-5.4-mini", input=prompt)
    return resp.output_text
La salida real para el top 3:
Léela con atención, porque tiene lección.
Las tesis se apoyan en datos reales. Todos los números salen de nuestros datos. Pero el LLM cometió dos pequeños errores:
Escribió el sentimiento de SanDisk (0,735) como "73,5 %". El sentimiento no es un porcentaje.
Dejó el momentum de Dell como "a 1.635 gain" en lugar de 163,5 %.
Ni un PER inventado. Ni un beneficio alucinado. Solo fallos de formato que un revisor detecta en segundos.
Limita el LLM a tus datos y sus errores pasan de peligrosos a cosméticos.
Lo que me enseñó el selector de acciones con IA
Lo más útil no fue la acción número 1. Fue este gráfico:
Tecnología es el 20,6 % del universo. Y el 85 % del top 20 (17 de 20).
El modelo no está roto. Ahora mismo, las empresas de memoria, almacenamiento y equipos de semiconductores lideran a la vez en momentum, crecimiento y sentimiento. Un modelo de factores premia exactamente eso.
Pero si compraras el top 20 a ciegas no tendrías una cartera diversificada. Tendrías una sola apuesta grande por el ciclo del hardware de IA.
Hay una segunda trampa, más pequeña. ASML aparece dos veces en el top 20: ASML (la cotización en EE. UU.) y ASMLF (la línea OTC). La misma empresa con dos tickers. Quitar duplicados por empresa es una línea de código, una vez que lo ves.
Un AI stock picker de caja negra no te habría enseñado ninguno de los dos problemas.
A partir de aquí puedes construir:
Un ranking neutral por sector: puntúa las acciones dentro de cada sector y quédate con las 2 mejores de cada uno.
Otros universos: cambia el filtro del Screener por acciones europeas, empresas con dividendo o small caps.
Una alerta semanal: ejecuta el script de forma programada y mándate el top 10 por email.
Limitaciones, con honestidad
Esto no es un backtest. Las notas usan los fundamentales de hoy. Probarlas con precios pasados filtraría información del futuro. Un backtest de verdad necesita fundamentales point-in-time y acciones deslistadas para evitar el sesgo de supervivencia.
El consumo de la API suma. Una ejecución completa con 200 acciones cuesta unas 2.000+ llamadas a EODHD, porque cada petición de fundamentales cuenta como 10. El plan gratuito sirve para probar, no para esto.
Los pesos son una elección, no una verdad. 25/25/20/15/15 es un punto de partida razonable. Cámbialos y el ranking cambia.
Ideas clave
Un selector de acciones con IA es datos + puntuación + explicación. La ventaja está en los datos, no en el modelo.
Usa el LLM para explicar elecciones a partir de números reales, nunca para elegir.
La transparencia te deja ver problemas, como un 85 % de concentración en un sector, antes de que te cuesten dinero.
Preguntas frecuentes
❓ ¿Existe algún AI stock picker gratis?
✅ Sí. Prospero.ai tiene una app gratuita, y Danelfin y Kavout tienen planes gratuitos con rankings limitados. Si quieres control total, el script de Python de este artículo es gratis de ejecutar. Solo pagas la API de datos y unos céntimos de LLM.
❓ ¿Puede ChatGPT elegir acciones?
✅ No de forma fiable por sí solo. Sin datos en tiempo real, ChatGPT puede citar números desactualizados o inventados. Funciona bien como capa de explicación cuando le das datos reales y actuales de una API, como hemos hecho en el paso 4.
❓ ¿Son precisos los selectores de acciones con IA?
✅ Ninguno puede garantizar rentabilidad. Los modelos de factores como este ordenan las acciones según características que históricamente han importado (momentum, calidad, valor), pero la única forma de medir su precisión es un backtest bien hecho con datos point-in-time.
❓ ¿Qué datos necesita un selector de acciones con IA?
✅ Como mínimo: histórico de precios para el momentum, fundamentales (ROE, crecimiento, valoración) y, a ser posible, sentimiento de noticias. EODHD los cubre todos con una sola API key.
Conclusión
La mayoría de los inversores no necesita un AI stock picker más listo.
Necesita uno por dentro del que pueda ver.
En el siguiente artículo de la serie pasamos de ordenar cientos de acciones a analizar una a fondo: análisis de acciones con IA usando un LLM y estados financieros reales.
👉 Empieza a construir con EODHD APIs: Screener, Fundamentals, precios EOD y News Sentiment con una sola clave. Usa el código KEVIN10 al pagar para tener un 10 % de descuento.
Aviso: este artículo es solo educativo y no es una recomendación de inversión. Los rankings que aparecen son el resultado de un modelo de ejemplo a 1 de noviembre de 2026.