Las 6 mejores APIs y modelos de aislamiento de voz para desarrolladores de agentes de IA (2026, probados)
Precios revisados el 2026-11-16.
Tu agente de voz no falla por el ruido. Falla por una segunda voz.
El speech-to-text ya se defiende muy bien con el tráfico, los teclados y el aire acondicionado. Lo que sigue sin saber es a qué persona tiene que escuchar. Cuando un compañero, una tele o el agente de la mesa de al lado habla cerca del micro, el STT transcribe también esa voz, y tu LLM le contesta.
Si estás:
- montando un agente de voz con Pipecat, LiveKit o tu propio stack,
- sacando un bot telefónico o de call center,
- o depurando un agente que se interrumpe solo en llamadas reales,
esta es la capa que te falta.
TL;DR
- El speech-to-text gestiona bien el ruido. Pero sigue transcribiendo a una segunda persona que habla cerca del micro, y eso es lo que rompe los agentes de voz.
- Solo 2 de las 6 herramientas de esta lista están hechas para eliminar una segunda voz: Krisp Voice Isolation y Arctan Eigen. Los modelos open-source eliminan ruido o separan hablantes.
- En el benchmark abierto de Krisp (265 grabaciones, 11 configuraciones de STT), el WER bajó del 23.24% al 6.24% (−73%) con Krisp Voice Isolation.
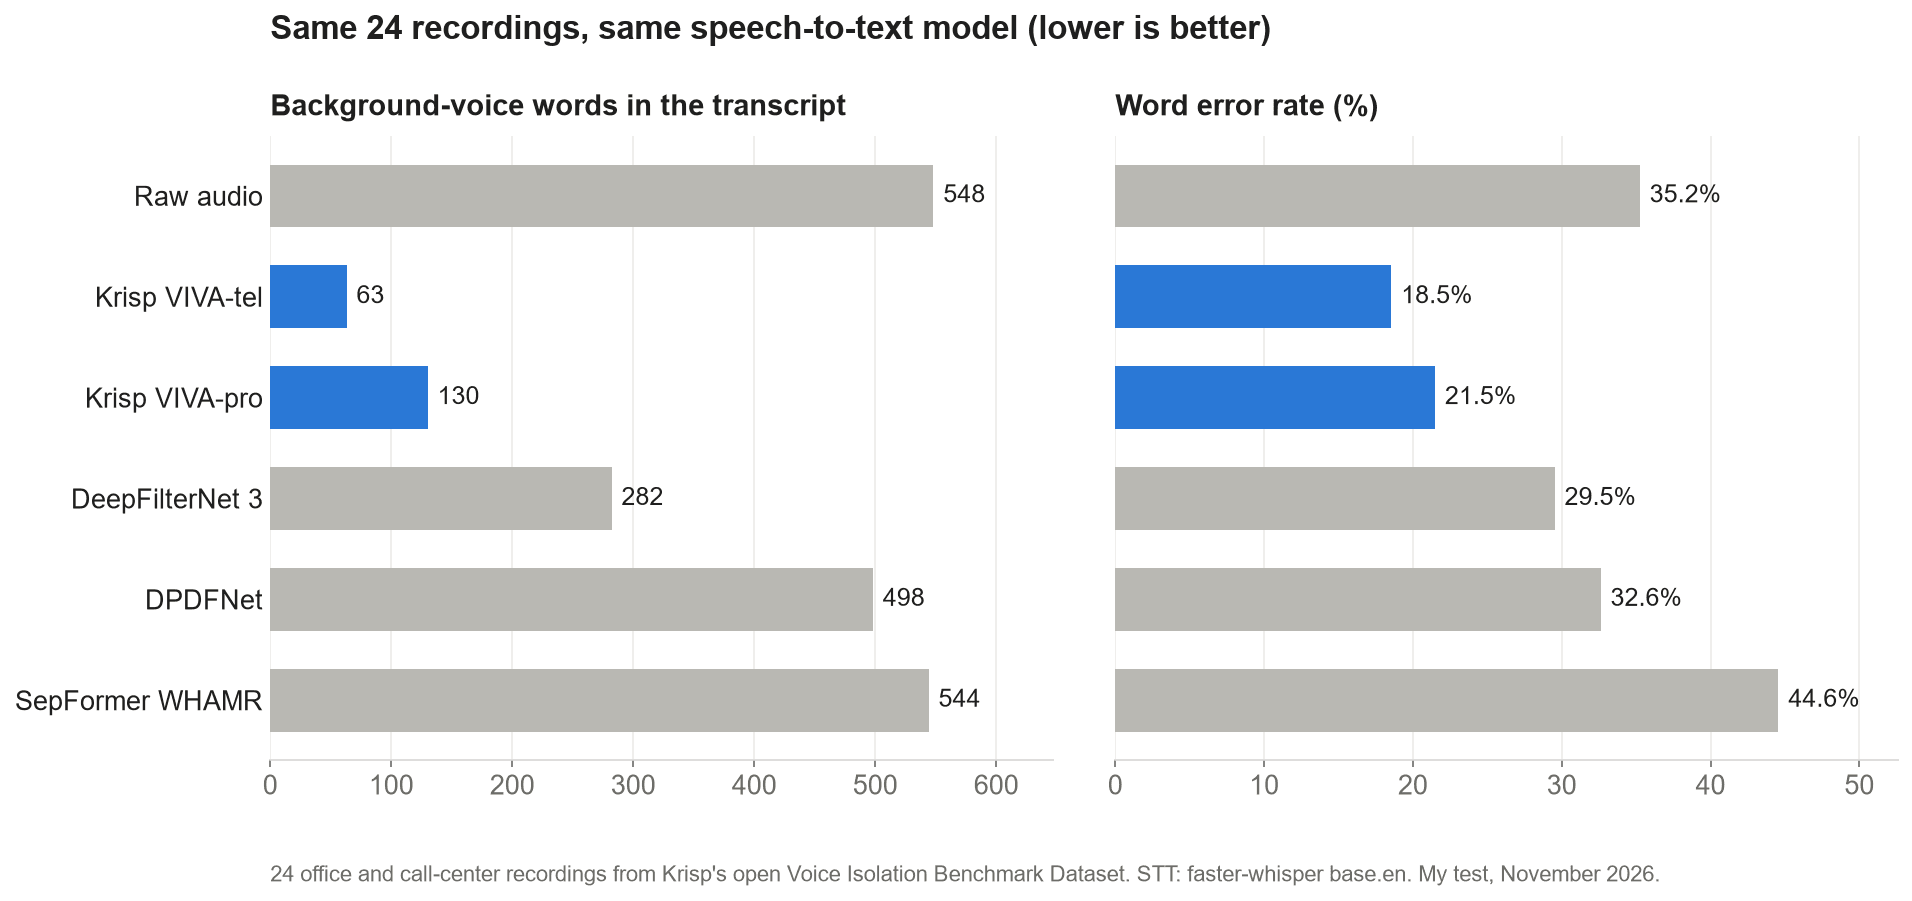
- En mi propia prueba (24 de esas grabaciones, un modelo de STT pequeño), Krisp bajó el WER del 35.2% al 18.5% y las palabras de la voz de fondo en la transcripción de 548 a 63.
- La API de Krisp cuesta $0.18 por hora de audio y empieza con $30 en créditos gratis.
Respuesta corta: para agentes de voz en producción me quedo con Krisp Voice Isolation. Elimina voces de fondo y ruido en tiempo real, en CPU, con una API self-serve y un SDK on-prem, y publica un benchmark abierto (dataset, salidas y harness) que cualquiera puede volver a ejecutar. Solo hay otra opción en la lista pensada para eliminar una segunda voz (Arctan). Los cuatro modelos open-source eliminan ruido o separan hablantes, que es otro trabajo distinto.
Pasé las mismas 24 grabaciones por todas las herramientas que pude ejecutar en mi máquina, transcribí cada una con el mismo STT y conté cuántas palabras de la otra persona acababan en la transcripción.
Audio original: 548 palabras de la voz de fondo.
Después de Krisp: 63.
Por qué los agentes de voz necesitan aislamiento de voz (y no solo cancelación de ruido)
El ruido es fácil de quitar porque no se parece al habla. Una segunda voz sí.
Ese es todo el problema. Un supresor de ruido aprende la forma de lo que "no es habla" y lo resta. Un compañero preguntando qué hay para comer es habla, así que pasa directo a tu STT.
Krisp le pone cifra. En su prueba para el lanzamiento de Voice Isolation 2.5, 10 sistemas de speech-to-text tuvieron de media un 2.10% de WER con audio limpio de un solo hablante y un 35.92% con una segunda persona hablando (post del lanzamiento).
En un agente de voz, eso se traduce en tres bugs que parecen bugs de lógica:
- Transcripciones erróneas. Las palabras de la segunda voz acaban en la transcripción y el LLM responde a cosas que quien llama nunca dijo.
- Falsas interrupciones. El agente oye a alguien de alrededor, cree que el usuario le ha cortado y deja de hablar.
- Turnos rotos. La voz de fondo hace parecer que el usuario sigue hablando, así que el agente nunca toma su turno.
La lógica de tu agente funciona tal como la diseñaste.
Lo que pasa es que reacciona a una voz que nunca debería haber oído.
Supresión de ruido vs aislamiento de voz vs separación de voces
Estos tres conceptos se confunden todo el rato, y las landing pages de los proveedores no ayudan. Para un agente, esta es la diferencia que importa:
| Técnica | Qué elimina | Salida | Ejemplo en esta lista |
|---|---|---|---|
| Supresión de ruido | Sonidos que no son habla (ventiladores, tráfico, tecleo) | Un stream, se mantienen todas las voces | DeepFilterNet, DPDFNet, ClearerVoice (modelos de mejora) |
| Aislamiento de voz | Ruido y voces de otras personas | Un stream: solo el hablante principal | Krisp Voice Isolation, Arctan Eigen |
| Separación de voces | Nada; divide la mezcla | N streams, uno por hablante. Eliges tú | SepFormer WHAMR, ClearerVoice (modelo de separación) |
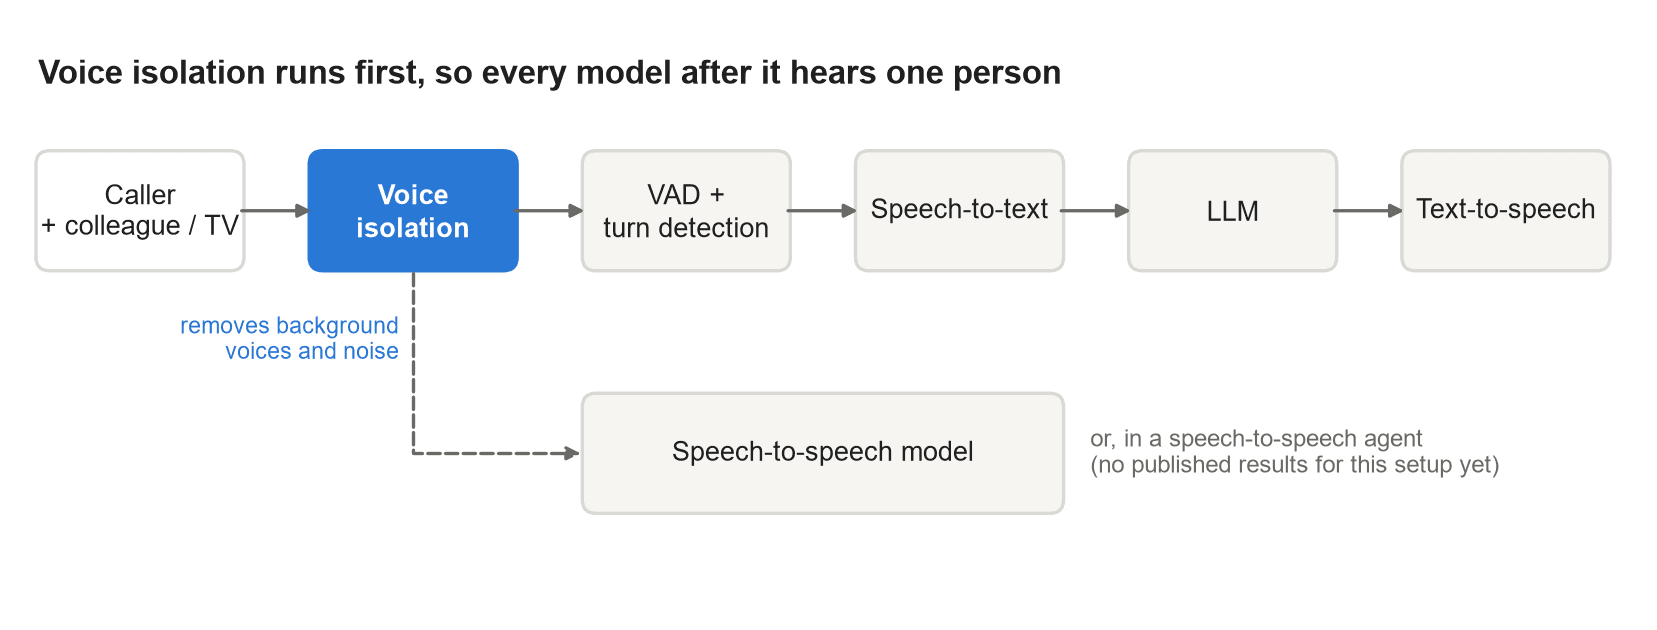
El aislamiento de voz va el primero en el pipeline, antes de la detección de actividad de voz (VAD), la detección de turnos y el STT. Si tu agente usa un modelo speech-to-speech en vez de una cadena STT → LLM → TTS, también puede ir delante de ese modelo (Krisp aún no ha publicado resultados para ese caso). En cualquier caso, todos los modelos que vienen después oyen a una sola persona.
Cómo lo probé
Misma entrada, mismo STT y misma puntuación para todas las herramientas.
- Audio: 24 grabaciones del Voice Isolation Benchmark Dataset abierto de Krisp (CC BY-NC 4.0): 12 de situaciones en casa y en la oficina, y 12 grabadas en call centers en funcionamiento. Elegí solo archivos con un tramo etiquetado en el que la segunda persona habla sola. La ficha del dataset dice que nada está mezclado de forma sintética.
- Entrada: los mismos 24 archivos para todas las herramientas, en PCM mono de 16 bits a 16 kHz. Dos excepciones: el modelo VIVA-pro de Krisp solo aceptaba los archivos originales a 32 kHz, y SepFormer solo funciona a 8 kHz, así que recibió una copia remuestreada. Todas las salidas llegaron al STT a 16 kHz.
- STT: faster-whisper
base.enen CPU (decodificación greedy, sin VAD, para que nada oculte la voz de fondo). Es un modelo pequeño, así que el WER absoluto es más alto que con un STT de producción. Lo que importa es la diferencia entre el audio original y cada herramienta, porque todas pasan por el mismo motor. - Métricas:
- WER frente a las transcripciones hechas a mano del dataset.
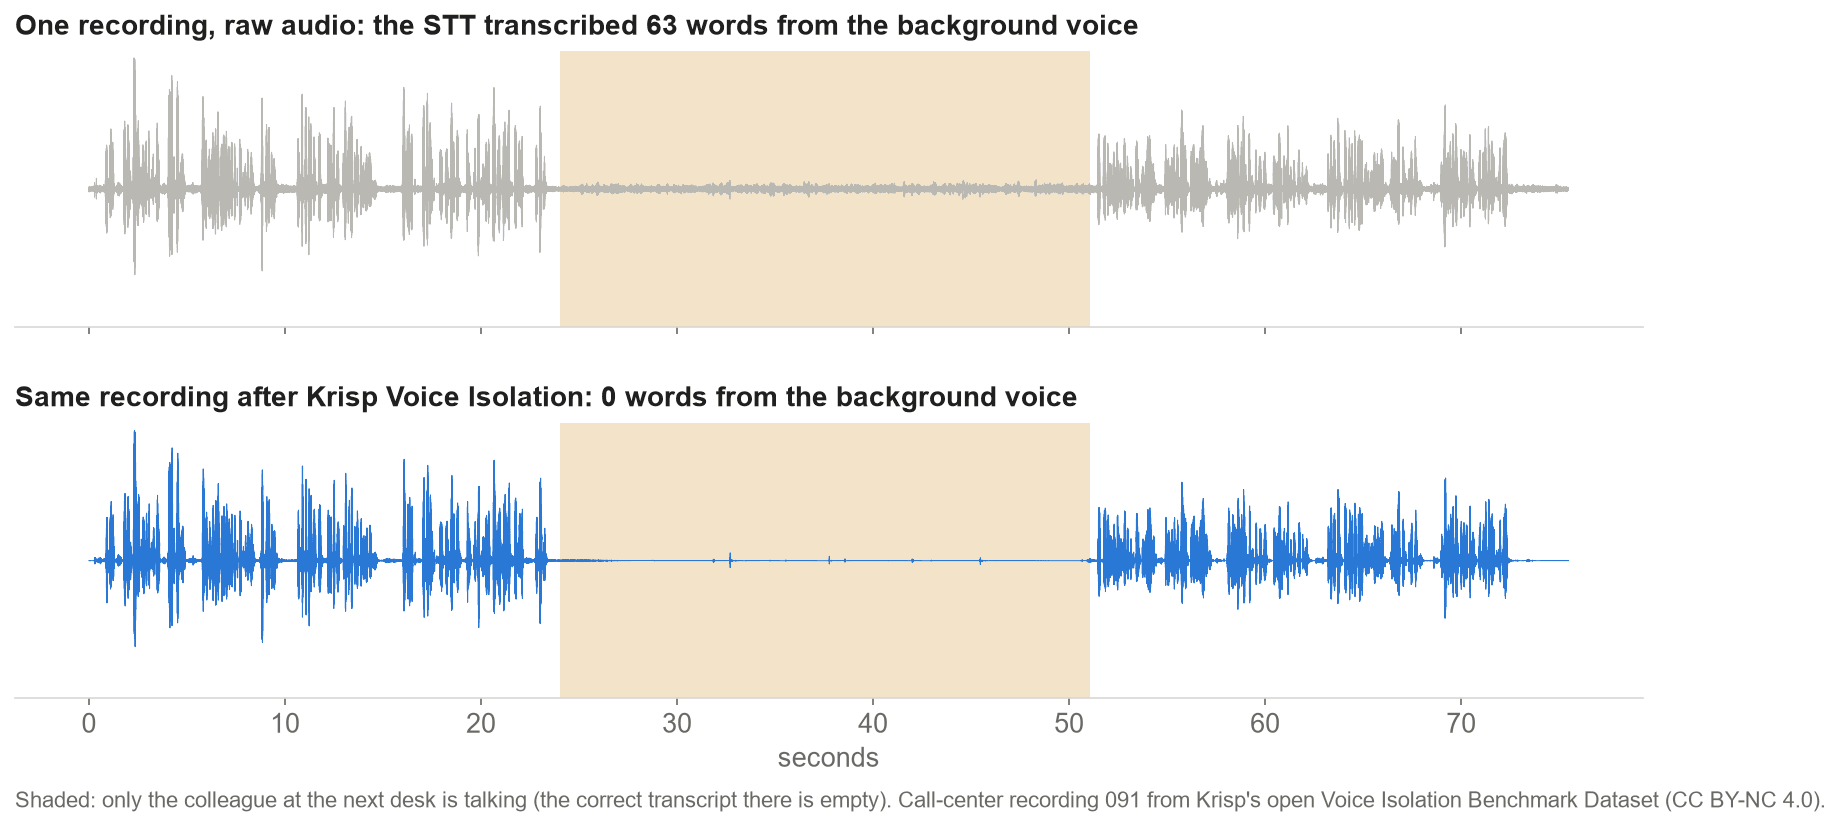
- Palabras filtradas: palabras transcritas en las ventanas en las que solo habla la voz de fondo. Ahí la transcripción correcta está vacía, así que cada palabra es una palabra que tu agente nunca debería haber oído.
- Velocidad en CPU: tiempo de procesamiento dividido entre la duración del audio en mi máquina (8 núcleos, sin GPU). Por debajo de 1.0 significa más rápido que el tiempo real.
Un aviso: el dataset lo grabó Krisp. Por eso usé sus datos públicos con mi propio STT y mi propio script de puntuación en lugar de sus cifras publicadas, y por eso puedo compartir las transcripciones en bruto y el script de puntuación si me los pides.
Resultados: quién eliminó de verdad la segunda voz
| Herramienta | WER (menos es mejor) | Palabras de la voz de fondo transcritas | vs original | Velocidad en CPU (procesamiento ÷ audio) |
|---|---|---|---|---|
| Audio original (sin procesar) | 35.2% | 548 | — | — |
| Krisp Voice Isolation (VIVA-tel, API) | 18.5% | 63 | −89% | Cloud, stream en tiempo real |
| Krisp Voice Isolation (VIVA-pro, API, 32 kHz) | 21.5% | 130 | −76% | Cloud, stream en tiempo real |
| DeepFilterNet 3 | 29.5% | 282 | −49% | 0.14 |
| DPDFNet (dpdfnet4) | 32.6% | 498 | −9% | 0.46 |
| SepFormer WHAMR (stream más fuerte) | 44.6% | 544 | −1% | 1.90 |
| ClearerVoice-Studio | Sin puntuar (demasiado lento en CPU) | — | — | 6.8+ (MossFormerGAN), 14.4 (FRCRN) |
| Arctan Eigen | No probado | — | — | — |
ClearerVoice fue demasiado lento en CPU para ejecutar el conjunto completo (detalles en su sección). 24 grabaciones, 3,198 palabras de referencia, 675 segundos en los que solo habla la voz de fondo. El WER es alto en todos los casos porque base.en es un STT pequeño; fíjate en las diferencias, no en los valores absolutos.
Hubo tres cosas que destacaron.
Krisp redujo los errores casi a la mitad (35.2% → 18.5%) y eliminó unas 9 de cada 10 palabras de fondo. En las 12 grabaciones de call center, el STT pasó de transcribir 234 palabras del agente de al lado a 4.
Los supresores de ruido no resuelven el problema de la segunda voz. DeepFilterNet eliminó más o menos la mitad de las palabras de fondo, probablemente donde la otra voz era lo bastante baja como para pasar por ruido, pero también duplicó las palabras que borró del hablante principal (88 → 184). DPDFNet dejó la segunda voz casi intacta, que es justo lo que debe hacer un supresor de ruido.
Separar no es aislar. SepFormer separó las voces, pero quedarme con el stream más fuerte eligió el equivocado tantas veces que la transcripción salió peor que sin hacer nada (17 de 24 archivos empeoraron).
Krisp tampoco fue perfecto. Empeoró ligeramente 5 de los 24 archivos, entre 0.5 y 2.4 puntos de WER, y en todos ellos el audio original apenas había captado la voz de fondo. Cuadra con lo que Krisp publica sobre su propio modelo: cuando no hay segunda voz, el aislamiento cuesta una fracción de punto.
Tabla comparativa
| Herramienta | Tipo | ¿Elimina una segunda voz? | Cómo se ejecuta | Licencia / precio | Frecuencias de muestreo | Latencia |
|---|---|---|---|---|---|---|
| Krisp Voice Isolation | Aislamiento de voz | Sí | API cloud (WebSocket) o VIVA SDK en tus servidores | API $0.18/h, $0.12/h en Growth. SDK en Enterprise | API: VIVA-tel 8/16 kHz, VIVA-pro 32 kHz. SDK 8–32 kHz | 15 ms algorítmica (~20 ms añadidos, docs del SDK) |
| Arctan Eigen | Aislamiento de voz | Sí (según el proveedor) | SDK (Node, Python, Rust, C++), on-prem en planes de pago | Desde $129/mes por 100,000 min | No indicado | <10 ms (proveedor) |
| DeepFilterNet | Supresión de ruido | No | Open-source, Python/Rust/CLI | MIT o Apache-2.0, gratis | 48 kHz | No indicada en el README |
| DPDFNet | Supresión de ruido | No | Open-source, ONNX en CPU | Apache-2.0, gratis | 8/16/48 kHz | ~20 ms hasta la primera salida, ~10 ms por bloque |
| ClearerVoice-Studio | Toolkit de mejora + separación | No (modelos solo de audio) | Open-source, basado en archivos | Apache-2.0, gratis | 16/48 kHz | No indicada |
| SepFormer WHAMR | Separación de 2 hablantes | Separa, no elige | Open-source (SpeechBrain) | Apache-2.0, gratis | Solo 8 kHz | No indicada |
1. Krisp Voice Isolation: mi primera opción para agentes de voz en producción
Krisp Voice Isolation mantiene al hablante principal y elimina las voces de fondo y el ruido de un stream de audio en directo. La versión actual, Voice Isolation 2.5, funciona en tiempo real en CPU y va delante de cualquier motor de STT. Puedes llamarla como API WebSocket self-serve o ejecutar el VIVA SDK en tus propios servidores, y Pipecat tiene un filtro de Krisp listo para usar. Si tu agente también habla con usuarios en otros idiomas, la misma cuenta de facturación cubre la API de traducción de voz de Krisp.
# Full script in Krisp's API quickstart
URL = "wss://streaming.krisp.ai/voice-isolation"
async with websockets.connect(URL, additional_headers=auth) as ws:
    await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000}))
    # then stream 30 ms PCM frames and read the cleaned frames back
El quickstart de la API tiene la versión completa, desde la API key hasta un WAV limpio.
Mi prueba: WER 35.2% → 18.5%, palabras de la voz de fondo 548 → 63 con el modelo por defecto de la API (VIVA-tel). En el benchmark abierto de Krisp (265 grabaciones, 11 configuraciones de STT), el WER bajó del 23.24% al 6.24% (análisis del benchmark). El mismo análisis también muestra dónde no ayuda: en llamadas telefónicas casi sin segunda voz, el WER pasó del 3.48% al 3.91%.
Pros
- Elimina la segunda voz, no solo el ruido.
- Dataset y benchmark públicos, así que puedes comprobar las cifras tú mismo.
- Pensado para códecs de telefonía y audio a 8 kHz, que es lo que reciben los agentes telefónicos.
Contras
- El SDK on-prem es solo para Enterprise, con precio negociado.
- Hecho para audio de campo cercano (hablante a unos 30 cm del micro como mucho).
Precio: Starter (pago por uso): $0.18/h, con $30 en créditos gratis válidos durante 12 meses. Growth: $400/mes con $400 de uso incluidos, a $0.12/h. Misma tarifa para VIVA-tel y VIVA-pro. SDK en Enterprise (precios).
Ideal para: equipos que sacan agentes de voz en llamadas reales (teléfono, call center, WebRTC) y necesitan que el agente oiga a una sola persona.
2. Arctan Eigen: una opción comercial con plan on-prem
Arctan Eigen es un producto de aislamiento de voz en tiempo real para agentes de voz. Ataca el mismo problema que Krisp. El lema de su web es "Only the Primary speaker gets through." Ofrece SDKs propios para Node, Python, Rust y C++, y un filtro para Pipecat mantenido por la comunidad.
No lo probé yo, así que todo lo que sigue sale de la web de Arctan.
Arctan afirma una latencia de procesamiento de 10 ms y una reducción del WER del 57%. Su home también muestra un gráfico de WER cara a cara frente a otros proveedores de aislamiento, Krisp incluido. La metodología está "disponible bajo petición" y el dataset no es público, así que no puedo verificar esas cifras ni compararlas con el benchmark abierto de arriba.
Pros
- Hecho a propósito para eliminar conversaciones de fondo, no solo ruido.
- Despliegue on-premise en los planes Startup y Pro.
- Prueba gratis de 14 días.
Contras
- No hay dataset ni metodología pública detrás de las cifras que publica.
- La web no indica las frecuencias de muestreo ni la tarifa por exceso de uso.
- El filtro de Pipecat lo mantiene la comunidad y valida la licencia por red.
Precio: Startup $129/mes con 100,000 minutos, Pro $499/mes con 500,000 minutos, Enterprise a medida (precios).
Ideal para: volumen mensual alto y predecible, donde un plan fijo con minutos incluidos encaja en tu presupuesto.
3. DeepFilterNet: la mejor base gratuita de mi prueba
DeepFilterNet es un framework open-source de mejora de voz muy usado (unas 5,000 estrellas en GitHub): supresión de ruido full-band a 48 kHz, librerías en Python y Rust, un binario deep-filter precompilado y un plugin LADSPA.
pip install deepfilternet
from df import enhance, init_df
model, df_state, _ = init_df()
clean = enhance(model, df_state, noisy_audio)
En mi máquina Windows el paquete de Python no compiló (compila una extensión en Rust), así que usé la CLI precompilada oficial.
Mi prueba: WER 35.2% → 29.5%, palabras de la voz de fondo 548 → 282. También fue el modelo más rápido que ejecuté: 0.14 segundos de CPU por segundo de audio, remuestreo incluido. La pega está en la otra columna: borró el doble de palabras del hablante principal que el audio original (88 → 184). No sabe qué voz importa, así que recorta todo lo que suena a interferencia.
Pros
- Licencia permisiva (MIT o Apache-2.0).
- La opción más rápida en CPU de mi prueba.
- CLI
deep-filterprecompilada en la página de releases, así que te puedes saltar la compilación de Python.
Contras
- Hecho para ruido. Eliminó más o menos la mitad de las palabras de fondo, pero se llevó parte del hablante principal por el camino.
- Solo 48 kHz, así que el audio telefónico a 8 kHz hay que remuestrearlo.
- Sin releases desde la v0.5.6 (agosto de 2023).
Precio: gratis.
Ideal para: una base gratuita, y agentes self-hosted donde el problema es el ruido y no las personas.
4. DPDFNet (Ceva): supresión de ruido open-source con API de streaming
DPDFNet es una familia de modelos causales de supresión de ruido de Ceva, construida sobre DeepFilterNet2 con bloques RNN dual-path. Es la opción open-source más reciente de la lista (PyPI 0.6.0, julio de 2026) y trae una API de streaming documentada.
import soundfile as sf
import dpdfnet

audio, sr = sf.read("noisy.wav")
clean = dpdfnet.enhance(audio, sample_rate=sr, model="dpdfnet4")
sf.write("clean.wav", clean, sr)
Para audio en directo, dpdfnet.StreamEnhancer mantiene el estado de la RNN entre fragmentos. La primera salida llega a los 20 ms aproximadamente, y luego unos 10 ms por bloque.
Mi prueba: WER 35.2% → 32.6%, palabras de la voz de fondo 548 → 498. Mantuvo intacto al hablante principal (menos palabras borradas que el audio original) y dejó la segunda voz casi sin tocar. Es el comportamiento correcto para un supresor de ruido, y la razón por la que no puede arreglar un problema de segunda voz. Funcionó a 0.46 segundos de CPU por segundo de audio con el modelo dpdfnet4.
Pros
- Apache-2.0, funciona en CPU con ONNX, modelos de 8–14 MB.
- Soporte nativo de 8, 16 y 48 kHz, así que el audio de telefonía funciona sin remuestrear.
- API de streaming con latencia documentada.
Contras
- Elimina ruido, no voces. Una segunda persona pasa directa.
- Sin integración documentada con frameworks de agentes de voz; el pegamento lo escribes tú.
- Comunidad pequeña (menos de 200 estrellas en GitHub).
Precio: gratis (Apache-2.0). Pagas la CPU.
Ideal para: agentes self-hosted en sitios ruidosos donde una segunda voz es rara, como alguien que llama desde la calle.
5. ClearerVoice-Studio: un toolkit de investigación, no un filtro en tiempo real
ClearerVoice-Studio, del laboratorio de voz de Alibaba, reúne mejora de voz, separación de voces, superresolución y extracción del hablante objetivo detrás de una única interfaz ClearVoice. Su mejor modelo de mejora a 16 kHz, MossFormerGAN_SE_16K, reporta un PESQ de 3.47 en VoiceBank+DEMAND.
from clearvoice import ClearVoice
cv = ClearVoice(task="speech_enhancement", model_names=["MossFormerGAN_SE_16K"])
out = cv(input_path="noisy.wav", online_write=False)
cv.write(out, output_path="clean.wav")
La pega para agentes: el modelo de hablante objetivo que sí elegiría una voz es audiovisual. Necesita vídeo del hablante, y una llamada telefónica no lo tiene. La API trabaja con archivos y el uso en tiempo real no está documentado.
Mi prueba: no pude puntuarlo. En mi CPU, con la configuración por defecto, MossFormerGAN_SE_16K no terminó una grabación de 132 segundos en 15 minutos, y el más ligero, FRCRN_SE_16K, tardó 433 segundos en procesar un clip de 30 segundos. Eso es entre 7 y 14 veces más lento que el tiempo real, así que la prueba de 24 archivos habría tardado más o menos un día. Al menos en CPU, es una herramienta para trabajo offline por lotes, no para ponerla delante de una llamada en directo.
Pros
- Muchos modelos en un solo toolkit Apache-2.0.
- Tablas de benchmark en el README (PESQ para mejora, SI-SNRi para separación).
- Los pesos se descargan solos desde Hugging Face.
Contras
- No trae ningún modelo solo de audio que "mantenga al hablante principal".
- Basado en archivos, sin API de streaming documentada.
- En mi instalación, sus dependencias fijadas (NumPy inferior a 2, un soundfile antiguo) chocaron con los demás paquetes.
Precio: gratis.
Ideal para: limpieza offline de grabaciones e investigación, no agentes en directo.
6. SepFormer WHAMR (SpeechBrain): separación sin decisión
SepFormer WHAMR es un transformer que divide una mezcla de dos hablantes, con ruido y reverberación, en dos streams. Obtiene 13.7 dB de SI-SNRi en el conjunto de test de WHAMR!.
from speechbrain.inference.separation import SepformerSeparation
model = SepformerSeparation.from_hparams(source="speechbrain/sepformer-whamr",
                                         savedir="pretrained_models/sepformer-whamr")
sources = model.separate_file(path="mix_8k.wav")  # [batch, time, 2]
Ese último comentario es el problema para un agente. Obtienes dos streams y ninguna etiqueta que diga cuál es el de quien llama. En mi prueba me quedé con el stream más fuerte, porque la persona más cercana al micro suele sonar más alto, pero es una heurística de la que tendrías que hacerte cargo en producción.
Mi prueba: WER 35.2% → 44.6%, palabras de la voz de fondo 548 → 544. Quedarme con el stream más fuerte eligió al hablante equivocado tantas veces que 17 de 24 archivos salieron peor que el audio original. De los modelos que puntué, fue el único más lento que el tiempo real en mi CPU (1.9 segundos de procesamiento por segundo de audio), así que en CPU no puede seguir el ritmo de una llamada en directo.
Pros
- Separa voces de verdad, no solo ruido.
- Apache-2.0, unas pocas líneas con SpeechBrain.
Contras
- Solo 8 kHz, entrenado con habla leída (WSJ0).
- No elige al hablante principal.
- Sin API de streaming documentada; salió en 2021.
Precio: gratis.
Ideal para: separación de hablantes offline y baselines de investigación.
Cómo elegir una API de aislamiento de voz para tu agente
Empieza por la pregunta en la que falla tu agente.
- "Responde a cosas que quien llama nunca dijo." Tienes un problema de segunda voz. Usa aislamiento de voz: la API de Krisp para empezar, y el VIVA SDK si el audio no puede salir de tus servidores.
- "Solo tiene problemas en sitios ruidosos." Puede que te baste con un supresor de ruido. DPDFNet hace streaming en CPU a 8/16/48 kHz.
- "No puedo enviar audio a un cloud de terceros." El VIVA SDK de Krisp o el plan on-prem de Arctan, o un supresor open-source si puedes vivir sin eliminar voces.
- "Estoy limpiando grabaciones, no llamadas en directo." Las herramientas offline como ClearerVoice o SepFormer te sirven, y la latencia da igual.
Elijas lo que elijas, mídelo con tu audio. El propio benchmark de Krisp muestra que el aislamiento puede costar una fracción de punto en llamadas sin segunda voz, así que pruébalo antes de activarlo para todo el tráfico.
Preguntas frecuentes
¿Qué es una API de aislamiento de voz?
Una API que recibe audio en directo y devuelve solo la voz del hablante principal, sin el ruido de fondo ni las voces de otras personas. Va antes del VAD y el speech-to-text en el pipeline de un agente de voz, o delante de un modelo speech-to-speech.
¿Qué diferencia hay entre aislamiento de voz y cancelación de ruido?
La cancelación de ruido elimina los sonidos que no son habla. El aislamiento de voz también elimina las otras voces. En un agente de voz, la segunda voz es lo que provoca transcripciones erróneas y falsas interrupciones.
¿Necesito aislamiento de voz si mi STT ya gestiona bien el ruido?
Sí, si puede haber una segunda persona cerca del micro. En la prueba de Krisp, 10 sistemas de STT tuvieron de media un 2.10% de WER con audio limpio y un 35.92% con una segunda voz. Los motores de STT aguantan bien el ruido, pero no otra persona hablando.
¿Hay algún modelo de aislamiento de voz gratis y open-source?
De las herramientas de esta lista, las open-source son supresores de ruido (DeepFilterNet, DPDFNet, ClearerVoice) o separadores de hablantes que no eligen a ninguno (SepFormer). La API de Krisp trae $30 en créditos gratis, que cubren unas 166 horas de audio a $0.18/h.
¿El aislamiento de voz añade latencia?
Un poco. Krisp indica 15 ms de latencia algorítmica para VI 2.5 (unos 20 ms añadidos, según la documentación del SDK). El modo streaming de DPDFNet devuelve su primera salida a los 20 ms aproximadamente.
¿El aislamiento de voz funciona con LiveKit y Pipecat?
Krisp VIVA está disponible en los dos: Pipecat tiene un filtro de Krisp VIVA listo para usar, y LiveKit incluye Krisp VIVA entre sus opciones de cancelación de ruido.
El cambio
Antes el problema era el ruido. Los STT modernos ya lo resuelven en buena parte.
Ahora el problema es la segunda voz, y necesita su propia capa delante de tu agente.
Si eres una empresa de software o APIs y quieres explicar tu producto con contenido educativo de calidad (no marketing vacío), conecta conmigo en LinkedIn.