Web scraping con Claude Code: un flujo de trabajo real con Gaffa
Los scripts de scraping casi nunca fallan el primer día.
Fallan en silencio el décimo.
El script se ejecuta. Ninguna excepción. Aparece un CSV. Y en algún punto faltan 24 filas. Nadie se da cuenta hasta que los datos ya están en un dashboard.
Si estás:
- recopilando datos de productos, precios o catálogos,
- usando Claude Code para escribir tus scrapers,
- o cansado de scripts que "funcionan" pero devuelven la mitad de los datos,
Esto te interesa.
Le di a Claude Code un objetivo de scraping en lenguaje natural y las AI skills de Gaffa, y dejé que pasara de cero a un flujo de web scraping que funciona: descubrimiento, un scraper con paginación, exportación a CSV y verificación. Después intenté romperlo.
Cada número, error y salida que vas a ver sale de ejecuciones reales.
El problema real de los scrapers escritos por IA
Escribir un scraper es lo fácil. Claude lo hace a la primera.
Lo difícil es todo lo que lo rodea:
- Una paginación que se para una página antes de tiempo
- Páginas que a veces cargan despacio
- Errores que solo aparecen de vez en cuando
Ninguna de estas cosas lanza un error. El script termina, el CSV parece correcto y los datos están mal.
Estos fallos no se encuentran leyendo código. Se encuentran ejecutando el scraper contra la web real y comparando la salida con algo de lo que te puedas fiar.
Un scraper necesita pruebas, no solo código
La solución no es un prompt más listo.
Es un flujo en el que el agente pueda descubrir la web, construir contra las páginas reales y depurar los fallos con datos reales de las peticiones. Con comprobaciones que te avisen cuando la salida está mal.
Las AI skills de Gaffa cubren justo esos tres pasos:
/gaffa-find: le das una URL y un objetivo, y explora la web con un presupuesto de créditos hasta encontrar la respuestagaffa-authoring: se carga sola cada vez que pides código de scraping, y obliga a Claude a capturar la página real antes de escribir un selector/gaffa-debug: le pasas el id de una petición fallida (brq_...) y diagnostica qué salió mal
Por debajo, Gaffa es una API REST de automatización de navegador: envías una URL y una lista de acciones (click, wait, capture_element, loop...) y las ejecuta en un navegador real.
👉 Puedes crear una cuenta en gaffa.dev y seguir los pasos conmigo.
Configuración con un solo comando
Si leíste mi artículo anterior sobre cómo conectar Claude Code con Gaffa, ya lo tienes. Si no, es un solo comando en la carpeta de tu proyecto:
npx @gaffa-dev/cli install --tools=claude-code --scope=project -y
Installed the gaffa skills (version 0.9.0) into 1 place:
  ./.claude\skills  (project)  gaffa-authoring, gaffa-debug, gaffa-find, gaffa-support

Registered the gaffa-docs MCP server:
  Claude Code  ./.mcp.json  added
Después define GAFFA_API_KEY como variable de entorno. Las skills no leen la clave de ningún otro sitio.
El objetivo de esta prueba es books.toscrape.com, un catálogo de prueba pensado para practicar scraping: 1.000 libros, 50 categorías y la paginación clásica con enlace "next".
Fase 1: descubre la web con /gaffa-find
No le di a Claude la URL de la categoría, ni un selector, ni el número de páginas. Solo la página de inicio y un objetivo:
/gaffa-find https://books.toscrape.com/ — Goal: I want to collect every book
in the 'Mystery' category. Find the category page URL, how many books it
contains, how many listing pages it spans and how pagination works, and which
fields each book card exposes (title, price, rating, availability, link).
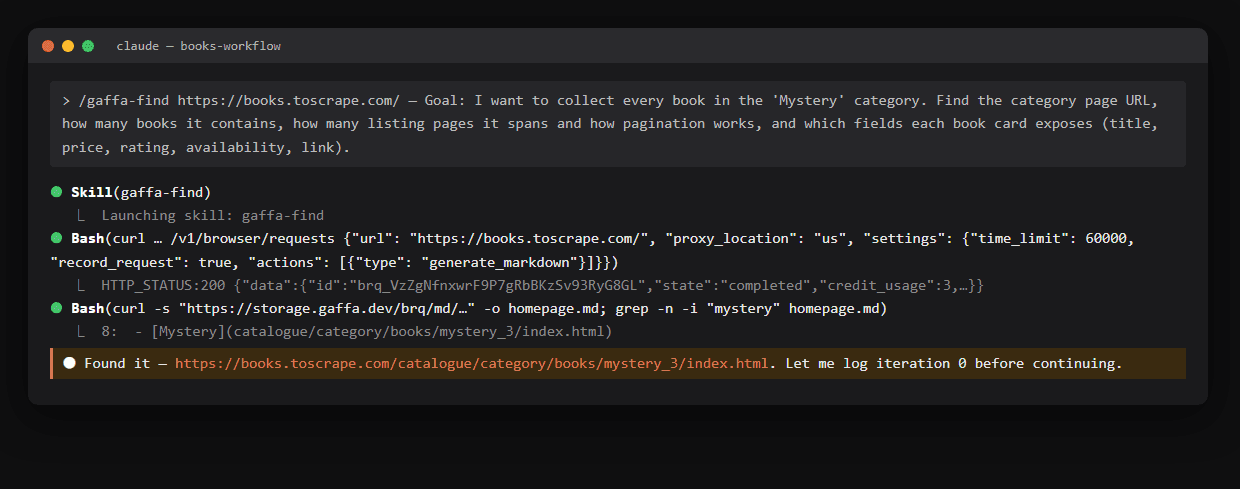
Reconstruida a partir de la transcripción real de la sesión.
La skill trabaja en bucle: reconocimiento, hipótesis, extracción dirigida y validación. Con límites estrictos: 15 peticiones y 50 créditos por ejecución, y 5 iteraciones como máximo.
Para el reconocimiento, envió una petición de navegador que convierte la página de inicio en Markdown. 3 créditos, 5,8 segundos, y la respuesta estaba en la barra lateral:
- [Mystery](catalogue/category/books/mystery_3/index.html)
A partir de ahí capturó la página de la categoría dos veces: una en Markdown (para leer "32 results" y "Page 1 of 2") y otra en HTML sin procesar (para ver el marcado que el Markdown elimina, como la valoración con estrellas). Después revisó la página 2 para confirmar dónde termina la paginación.
También dejó en disco un registro de razonamiento, .gaffa-find-<timestamp>.log, con una entrada por iteración: hipótesis, id de la petición, créditos y decisión. Puedes auditar exactamente cómo llegó a su respuesta.
El resultado final:
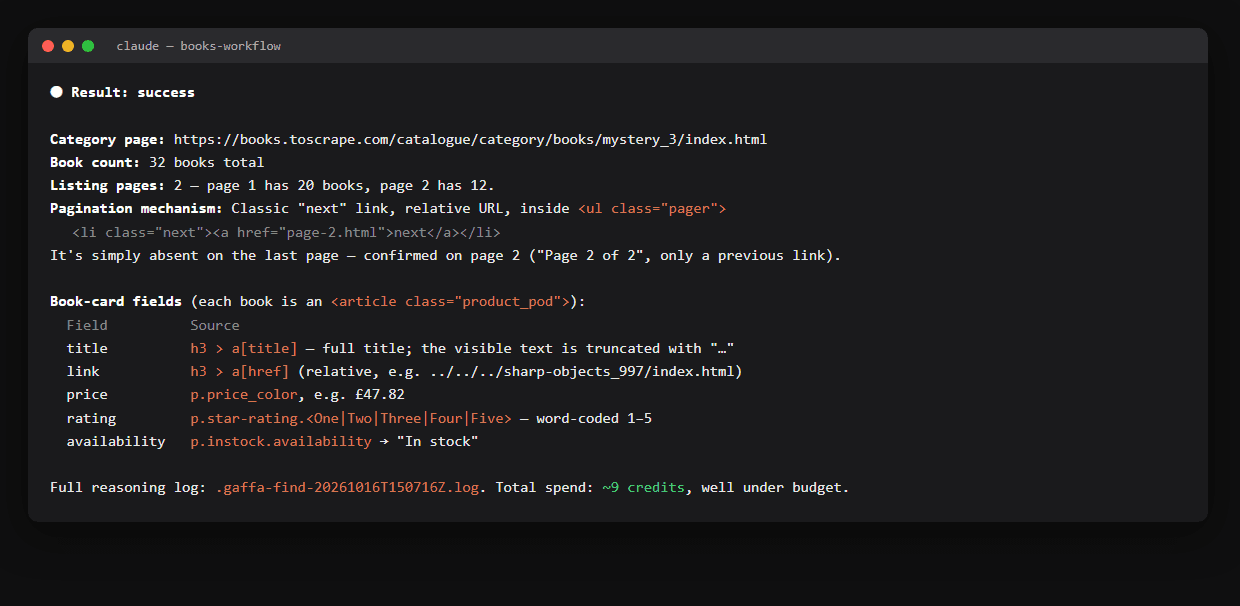
Reconstruida a partir de la transcripción real de la sesión.
Estado final: éxito. 32 libros, 2 páginas, paginación mediante un enlace relativo li.next a que desaparece en la última página, y un selector para cada campo. Un detalle que yo no habría visto: el título visible aparece recortado con "…", así que el título completo hay que sacarlo del atributo title del enlace.
Coste del descubrimiento: 9 créditos.
Fase 2: convierte lo descubierto en un flujo de trabajo
Misma sesión de Claude, así que conservaba todo lo que había aprendido. Esta vez le pedí un flujo de verdad:
Rewrite it as books_to_csv.py: one single Gaffa browser request that
paginates with the loop action. Price as a number, rating as an integer
1-5, absolute product URL. Write a CSV. Add --category-url. Run it on
Mystery, verify 32 rows with no duplicates, then run it on a category
with 3+ pages and verify the count matches the 'N results' text.
Claude consultó la referencia de loop a través del servidor MCP de la documentación de Gaffa (esta vez sí estaba aprobado) y construyó la petición.
Una petición, todas las páginas
Este es el corazón del flujo. En lugar de una petición por página, una sola petición captura una vez el contador de resultados y después entra en bucle: captura la cuadrícula de productos, pulsa "next" y repite hasta que no hay enlace "next".
"actions": [
    {"type": "capture_element", "selector": "form.form-horizontal", "custom_id": "results-banner"},
    {
        "type": "loop",
        "custom_id": "pagination-loop",
        "max_iterations": max_pages,
        "timeout": loop_timeout,
        "stop_on_fail": True,
        "continue_on_fail": True,  # the last page has no "next": that's how the loop ends
        "actions": [
            {"type": "wait", "time": 800, "custom_id": "settle"},
            {"type": "capture_element", "selector": "ol.row", "custom_id": "page-cards"},
            {"type": "click", "selector": "li.next a", "custom_id": "next-page", "timeout": 15000},
        ],
    },
],
El análisis se hace en Python puro con expresiones regulares sobre el HTML capturado. Sin extracción con LLM. La skill aparta a Claude de la acción parse_json de Gaffa en páginas estructuradas como esta, porque un parser determinista es más barato y devuelve lo mismo en cada ejecución.
La comprobación que detectó un fallo
La línea más valiosa del script no es el scraper. Es esta:
status = "OK" if reported_total == len(books) else "MISMATCH"
print(f"page says {reported_total} results; scraped {len(books)} -> {status}")
if status == "MISMATCH":
    sys.exit(1)
El flujo compara su propia salida con el número que muestra la web. Si no coinciden, falla y lo dice bien alto.
Así fue la fase 2:
Intento 1: Mystery. 32 de 32 libros, 32 URLs únicas y el contador coincide. 3 créditos.
Intento 2: Nonfiction (110 libros, 6 páginas).
request: brq_VzZhqRu7EsTn47GhMyLqkSN76iJDA6
pages captured: 6
books written: 86 -> nonfiction.csv
page says 110 results; scraped 86 -> MISMATCH
Se capturaron las 6 páginas, pero faltaban 24 libros. Claude lo desglosó página a página:
page 1: articles=20
page 2: articles=20
page 3: articles=20
page 4: articles=12
page 5: articles=14
page 6: articles=2
Las páginas 4 a 6 se capturaron mientras el navegador todavía las estaba cargando, justo después del clic. Claude añadió un wait breve al principio de cada iteración y volvió a ejecutarlo: 110 de 110. Después repitió Mystery para asegurarse de que no se había roto nada.
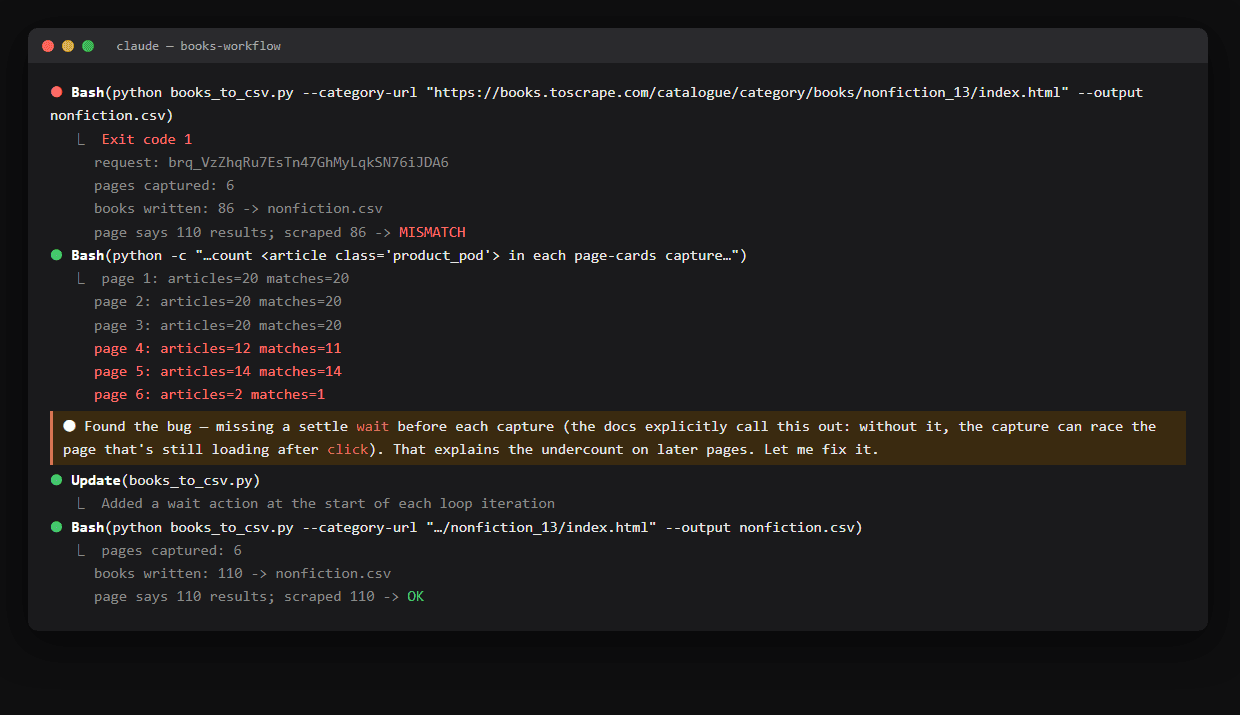
Reconstruida a partir de la transcripción real de la sesión.
Sin esa comprobación del recuento, el script habría terminado con código 0 y me habría entregado un CSV al que le faltaba el 22 % de los datos.
Coste de la fase 2: 6 peticiones cobradas, 18 créditos.
Después intenté romperlo
Claude dijo que había terminado. No me fié. Ejecuté yo mismo el script en categorías que no había visto nunca.
Travel (11 libros) y Fiction (65 libros, 4 páginas) cuadraron con sus recuentos. Luego volví a ejecutar Nonfiction:
pages captured: 2
books written: 40 -> nonfiction.csv
page says 110 results; scraped 40 -> MISMATCH
El bucle se paró después de la página 2. La comprobación del recuento lo volvió a detectar.
Las peticiones fallidas o incompletas son parte normal del scraping de cualquier web real. Las páginas se ralentizan, los diseños cambian, el contenido carga tarde. Lo importante es lo rápido que descubres el porqué. Ese es el trabajo de la tercera skill.
Fase 3: diagnostica con /gaffa-debug
Le pasé a Claude el id de la petición:
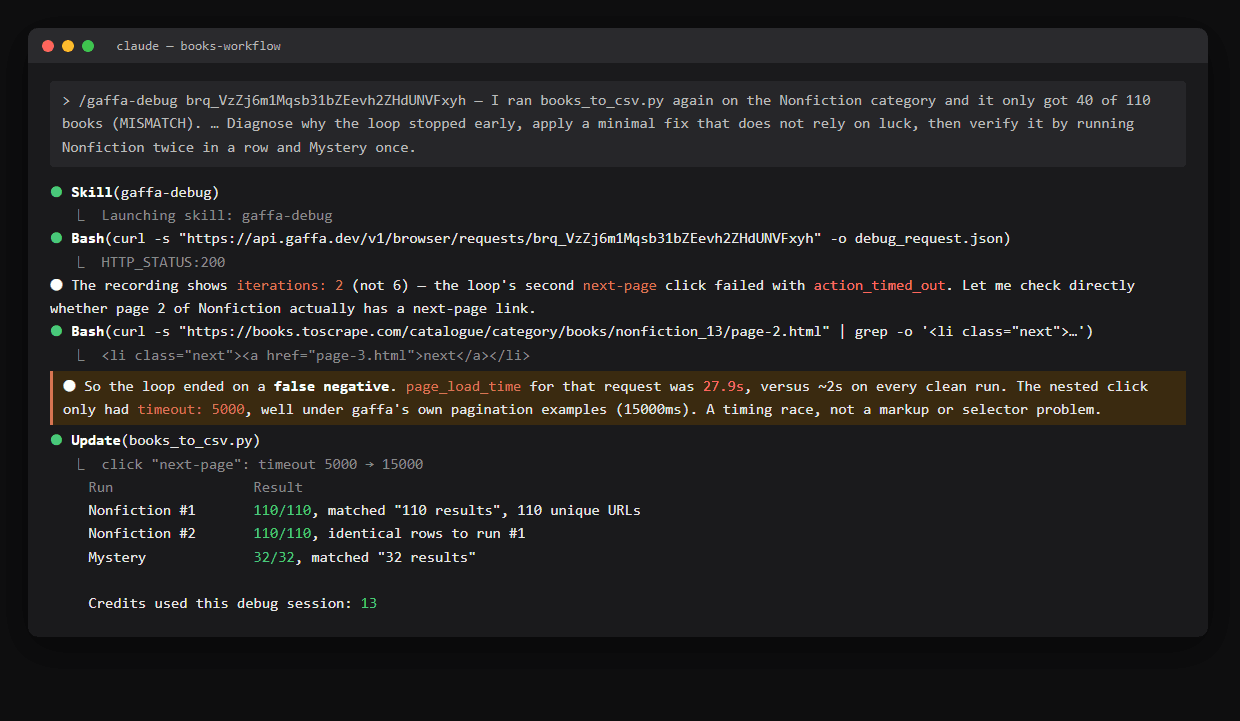
/gaffa-debug brq_VzZj6m1Mqsb31bZEevh2ZHdUNVFxyh — it only got 40 of 110
books (MISMATCH). Diagnose why the loop stopped early, apply a minimal fix
that does not rely on luck, then verify on Nonfiction twice and Mystery once.
Reconstruida a partir de la transcripción real de la sesión.
El diagnóstico fue preciso:
- Los datos de la petición mostraban que el bucle hizo 2 iteraciones, y que el segundo clic en "next" falló con
action_timed_out. - ¿Era la página 2 realmente la última? Claude descargó
page-2.htmldirectamente (gratis, sin llamar a Gaffa). Tiene un enlace "next" a la página 3. Así que el bucle se paró antes de tiempo por error. - ¿Por qué? En esa ejecución la página tardó 27,9 segundos en cargar, frente a unos 2 segundos en todas las demás. Las webs reales tienen momentos lentos, y el clic solo esperaba 5 segundos antes de rendirse.
El parche fue un solo valor: subir el timeout del clic de 5.000 a 15.000 ms, el mismo valor que usan los ejemplos de paginación de la propia Gaffa. Una última página de verdad sigue cerrando el bucle, solo que 15 segundos más tarde.
Verificación: Nonfiction 110 de 110 dos veces seguidas con filas idénticas, y Mystery 32 de 32. 13 créditos.
El resultado final
Ejecuté el script final una última vez por mi cuenta:
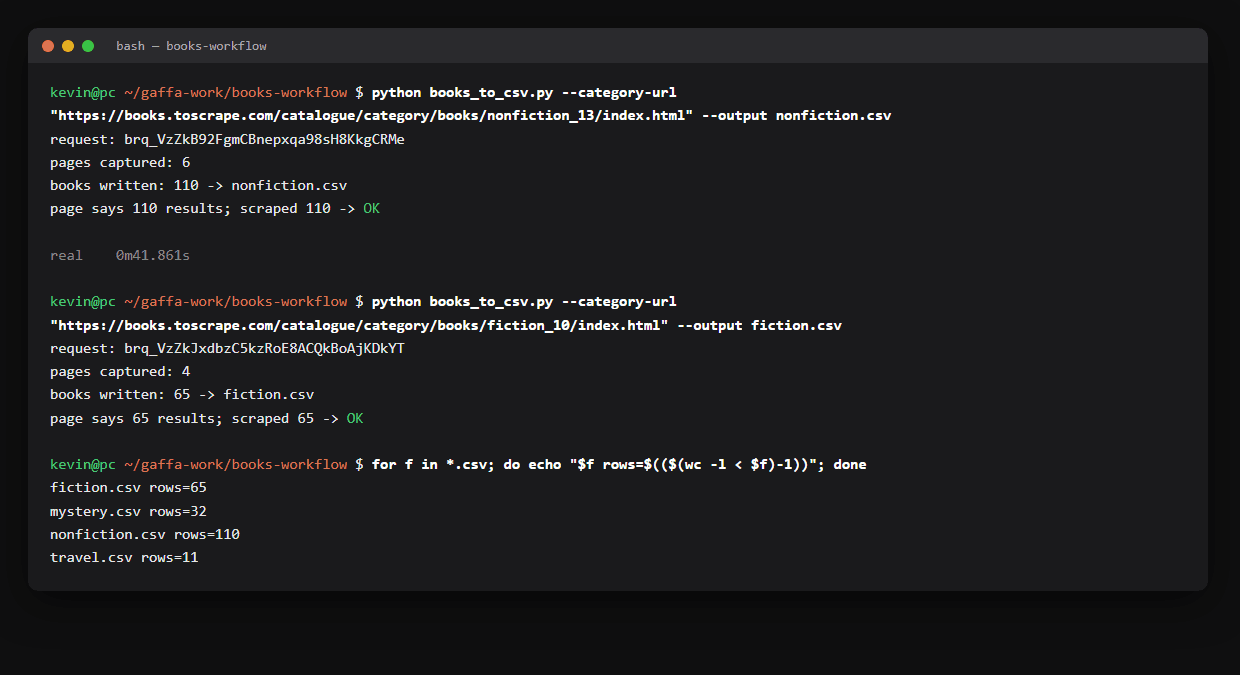
| Categoría | Páginas | Libros extraídos | La web dice | Estado | Créditos |
|---|---|---|---|---|---|
| Mystery | 2 | 32 | 32 | OK | 3 |
| Travel | 1 | 11 | 11 | OK | 2 |
| Fiction | 4 | 65 | 65 | OK | 4 |
| Nonfiction | 6 | 110 | 110 | OK | De 3 a 5 |
218 libros, 4 categorías, 0 duplicados. Nonfiction, 6 páginas en una sola petición, tarda unos 42 segundos de principio a fin.
El CSV contiene datos limpios y tipados, listos para pandas o una hoja de cálculo:
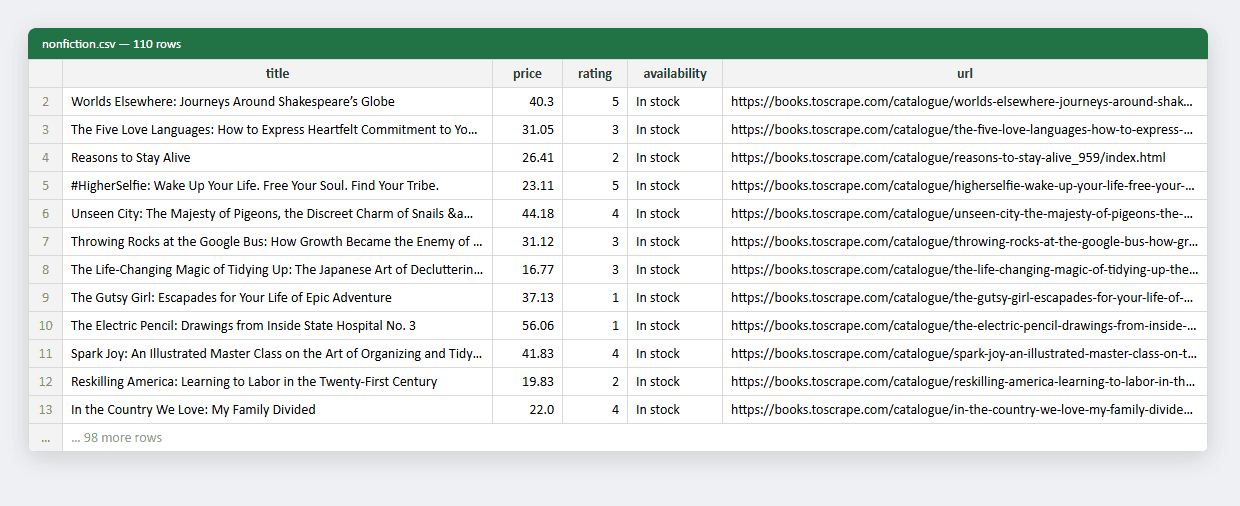
title,price,rating,availability,url
Worlds Elsewhere: Journeys Around Shakespeare’s Globe,40.3,5,In stock,https://books.toscrape.com/catalogue/worlds-elsewhere-journeys-around-shakespeares-globe_972/index.html
The Five Love Languages: How to Express Heartfelt Commitment to Your Mate,31.05,3,In stock,https://books.toscrape.com/catalogue/the-five-love-languages-how-to-express-heartfelt-commitment-to-your-mate_969/index.html
Reasons to Stay Alive,26.41,2,In stock,https://books.toscrape.com/catalogue/reasons-to-stay-alive_959/index.html
Cuánto costó todo
| Fase | Créditos de Gaffa |
|---|---|
Descubrimiento con /gaffa-find | 9 |
| Construcción del flujo | 18 |
Arreglo y verificación con /gaffa-debug | 13 |
| Total de Claude Code | 40 |
| Mis propias pruebas | 20 |
Claude Code funcionó dentro de mi suscripción de Claude Pro.
A partir de aquí puedes:
- programarlo con cron o con el Programador de tareas de Windows, ya que termina con código 1 si hay un desajuste
- recorrer las 50 URLs de categoría para montar el catálogo completo de 1.000 libros
- aplicar el mismo patrón a cualquier listado paginado: portales de empleo, cuadrículas de productos o directorios
Qué haría distinto la próxima vez
Tres lecciones de esta prueba, y todas sirven más allá de Gaffa:
Pon la verificación en el script, no en tu cabeza. La comprobación de "N results" detectó dos fallos silenciosos que, de otro modo, habrían llegado a producción. Si la web te dice cuántos elementos tiene, úsalo.
Depura con los datos de la petición, no con suposiciones. /gaffa-debug no adivinó. Leyó cuántas iteraciones se ejecutaron, qué acción falló y cuánto tardó la página en cargar, y después comprobó la página real antes de cambiar un solo valor.
Las esperas fijas son apuestas. El wait de 800 ms funcionó de casualidad, y el timeout de 5 s del clic no aguantó cuando la web fue lenta. Siempre que puedas, espera a un selector o da a los timeouts un margen real.
Puntos clave
/gaffa-findconvirtió "recoge todos los libros de Mystery" en URLs, selectores y reglas de paginación con 9 créditos.- Una sola petición de Gaffa con
loopextrajo una categoría de 6 páginas en unos 42 segundos, y una comprobación del recuento integrada detectó dos pérdidas de datos silenciosas. /gaffa-debugatribuyó un bucle detenido a una carga de página de 27,9 segundos y lo arregló cambiando un solo timeout.
Conclusión
Claude Code escribe scrapers rápido. Ese nunca fue el cuello de botella.
El cuello de botella era saber si los datos están bien.
Dale al agente un navegador real, skills que le obliguen a mirar antes de escribir y un flujo que compruebe su propia salida, y el web scraping con Claude Code pasa a ser algo en lo que de verdad puedes confiar.
👉 Pruébalo: crea una cuenta en gaffa.dev, ejecuta npx @gaffa-dev/cli install y empieza con /gaffa-find en una web de la que necesites datos.