← Volver a artículos
Paso 2: comprueba la instalación con
Cómo conectar Claude Code con Gaffa para automatizar el navegador
Claude CodeBrowser AutomationClaude SkillsAI Agent
Los agentes de IA para programar escriben muy bien código de automatización de navegador.
Lo que no saben es si funciona.
Pídele a Claude Code un script que rellene un formulario y extraiga el resultado, y tendrás algo que parece perfecto. Funciones limpias. Selectores con sentido. Luego lo ejecutas y el selector no existe, el desplegable está vacío o el contenido nunca llegó a cargar.
Si estás:
- creando scrapers o herramientas internas de automatización,
- usando Claude Code (o Cursor, Codex, Copilot) en tu día a día,
- o cansado de pegar HTML en bruto en una ventana de chat,
Esto te interesa.
En esta guía conecto Claude Code con Gaffa, una API de automatización de navegador, y dejo que el agente construya una automatización real contra una web real. Cada comando, salida y número que vas a ver sale de una ejecución de verdad.
El problema: los agentes escriben automatizaciones a ciegas
Este es el flujo habitual cuando le pides a un agente de IA una automatización de navegador:
- El agente adivina la estructura de la página a partir de la URL
- Se inventa nombres de clases que "probablemente" existen
- Ejecutas el script, falla y vuelves a pegar el error en el chat
Repite tres o cuatro veces.
El agente hace lo que puede sin ver nada. Nunca ve la página. Nunca ve lo que JavaScript pinta después de cargar. Nunca ve que un desplegable solo se rellena cuando eliges algo en otro.
Acabas haciendo de ojos del agente.
El problema real no es la inteligencia. Es el feedback.
Un modelo capaz de escribir un script de Playwright es perfectamente capaz de escribir uno bueno.
Lo que le falta es un navegador al que llamar, mirar y contra el que probar.
Dale al agente un navegador real detrás de una API, junto con instrucciones sobre cómo usarlo, y el ciclo cambia por completo: mirar la página, escribir la petición, ejecutarla, revisar la salida, corregir y repetir. Sin ti en medio.
Eso es exactamente lo que hacen las AI skills y la CLI de Gaffa.
Qué es Gaffa (y qué aportan las skills)
Gaffa es una API REST que ejecuta sesiones de navegador reales por ti. Le envías una URL y una lista de acciones, y te devuelve los resultados.
Entre las acciones disponibles están:
click,type,select,scroll,waitpara interactuar con la páginacapture_screenshot,capture_dom,generate_markdownpara leerlaparse_tableyparse_jsonpara convertirla en datos estructuradoslooppara repetir acciones, por ejemplo al recorrer una paginación
Sin SDK y sin navegador que alojar. Los proxies residenciales vienen incluidos, y elegir su ubicación es un solo campo (proxy_location).
Además de la API, Gaffa publica dos piezas open source para agentes de IA:
- gaffa-for-ai: cuatro skills para agentes (
gaffa-authoring,gaffa-find,gaffa-debug,gaffa-support) y un servidor MCP con la documentación. - gaffa-cli: una herramienta de línea de comandos que instala esas skills en Claude Code, Codex, Copilot, Cursor, Antigravity o Pi.
Lo interesante son las skills. No se limitan a describir la API. Le dicen al agente cómo comportarse: no adivinar nunca un selector, capturar primero la página real, fijar siempre un límite de tiempo, leer la clave de una variable de entorno y no imprimirla jamás.
👉 Puedes crear una cuenta en gaffa.dev y seguir los pasos conmigo.
Paso 1: instala las skills de Gaffa en tu proyecto
No hace falta instalar nada a nivel global. La CLI se ejecuta con npx.
Crea una carpeta de proyecto e instala las skills a nivel de proyecto:
mkdir quotes-bot && cd quotes-bot
npx @gaffa-dev/cli install --tools=claude-code --scope=project -y
Salida:
Installed the gaffa skills (version 0.9.0) into 1 place:
  ./.claude\skills  (project)  gaffa-authoring, gaffa-debug, gaffa-find, gaffa-support

For a project install, commit the skills directory and its .gaffa-skills.json to share it.

Registered the gaffa-docs MCP server:
  Claude Code  ./.mcp.json  added
Pasaron dos cosas:
- Las cuatro skills se instalaron en
.claude/skills/ - Se registró el servidor MCP de la documentación de Gaffa en
.mcp.json, para que Claude consulte la documentación directamente en lugar de adivinar
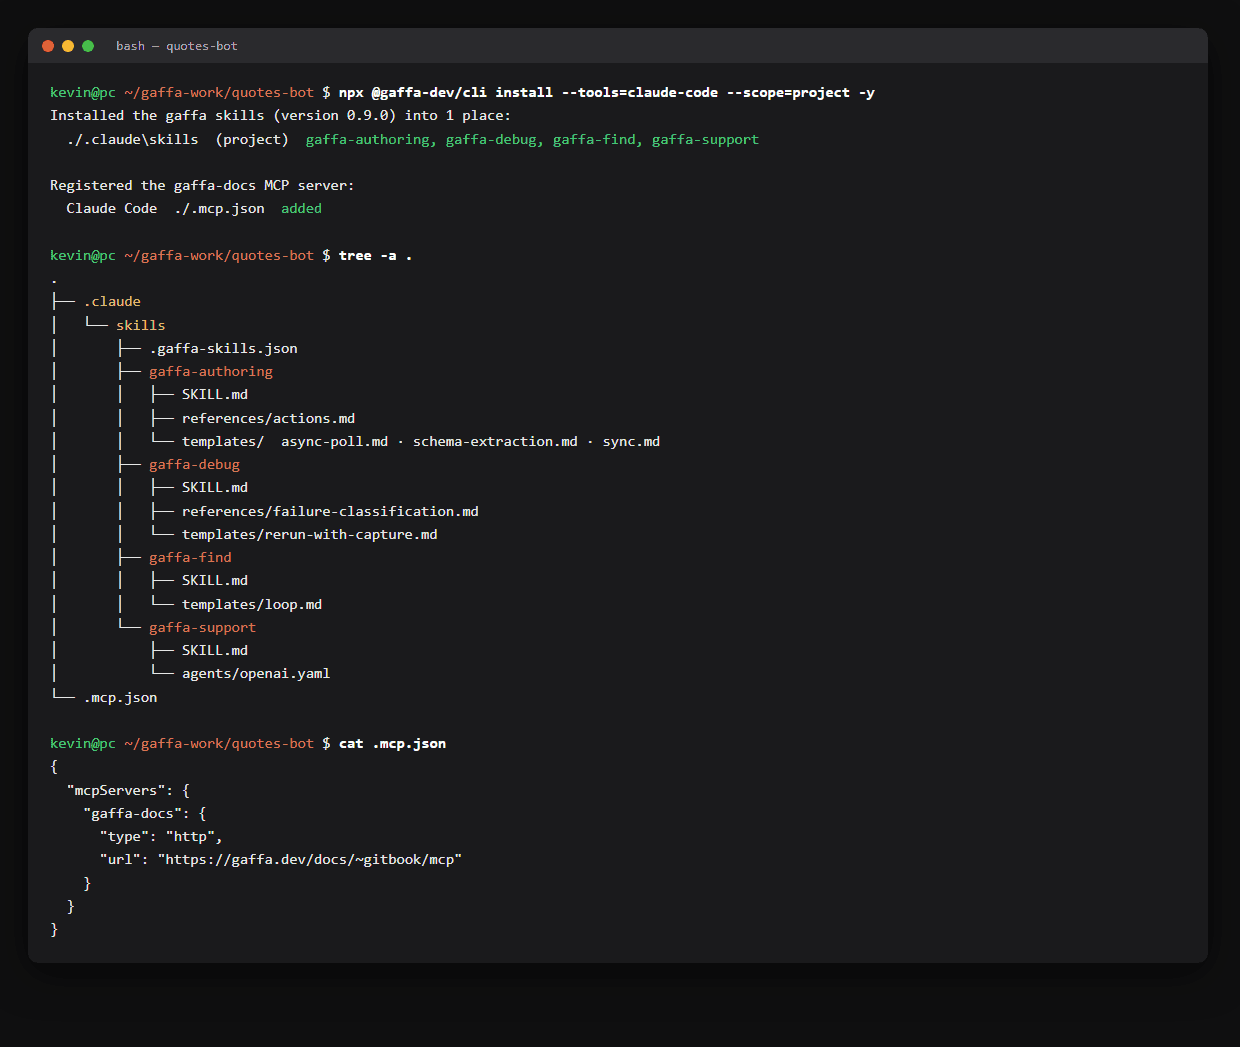
A nivel de proyecto puedes hacer commit de .claude/skills/ y todo tu equipo tendrá la misma configuración. Usa --scope=personal si las quieres disponibles en todos tus proyectos. Si lo ejecutas sin parámetros, la CLI te pregunta qué herramientas y qué alcance quieres.
Alternativa: instalarlo como plugin de Claude Code. El repositorio de las skills también funciona como marketplace de plugins:
claude plugin marketplace add https://github.com/GaffaAI/gaffa-for-ai
claude plugin install gaffa@gaffa --scope project
Mismas skills, mismo servidor MCP. Elige la opción que prefieras.
Paso 2: comprueba la instalación con doctor
doctor solo lee. Detecta qué herramientas de programación con IA tienes y si las skills de Gaffa están configuradas en cada una:
npx @gaffa-dev/cli doctor
Claude Code  installed
  config  ~\.claude
  skills  gaffa-authoring, gaffa-debug, gaffa-find, gaffa-support  (project: ~\gaffa-work\quotes-bot\.claude\skills)
...
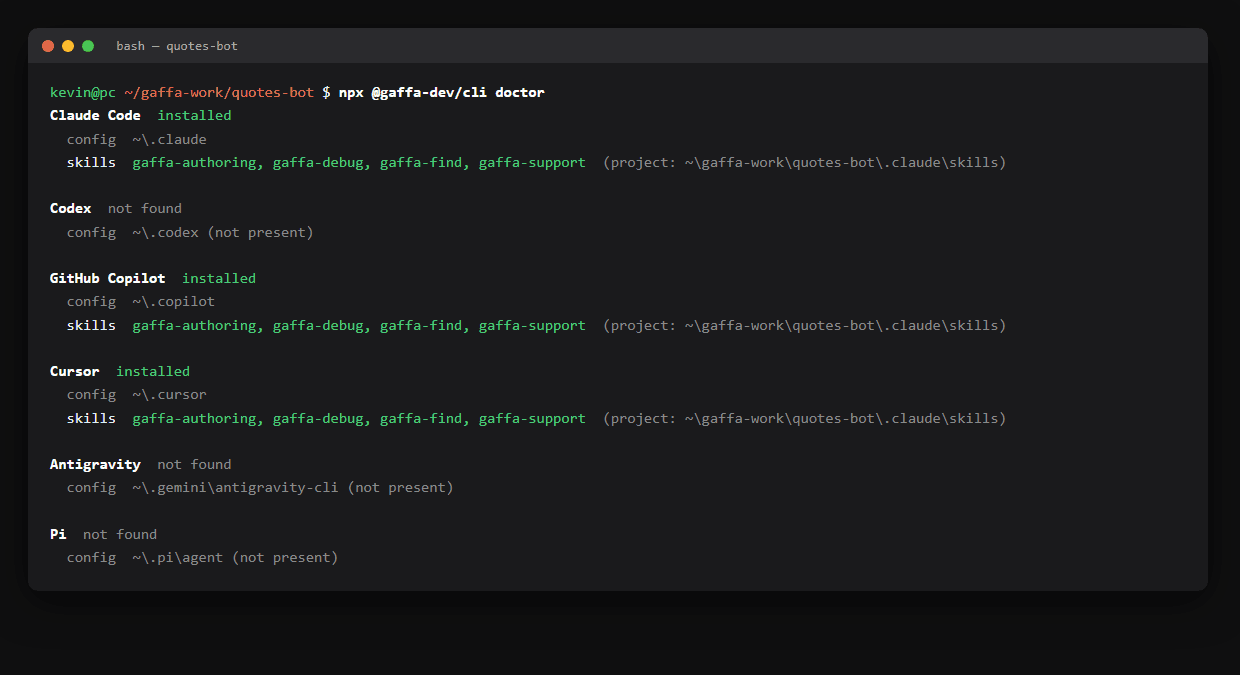
Tenlo en cuenta también para más adelante: doctor te avisa cuando tus skills están por detrás de la versión publicada, y volver a ejecutar install las actualiza.
Paso 3: añade tu API key
Las skills leen la clave de un único sitio: la variable de entorno GAFFA_API_KEY.
# macOS / Linux / Git Bash
export GAFFA_API_KEY="your_key_here"
# PowerShell
$env:GAFFA_API_KEY = "your_key_here"
Ponla en el perfil de tu terminal para no tener que pegarla en cada sesión. Y no la subas nunca al repositorio.
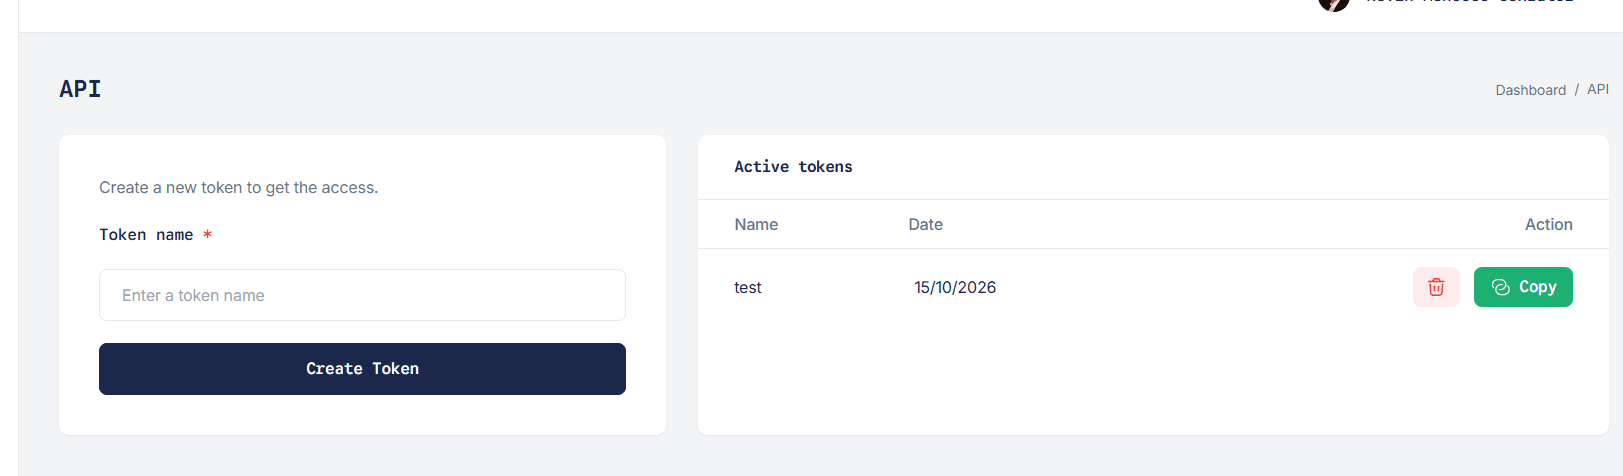
Crea un token en la sección API Keys del panel de Gaffa.
Antes de darle el control a Claude, me gusta confirmar que la clave y la red funcionan con una petición directa. Esta carga una página renderizada con JavaScript y la devuelve en Markdown:
curl -sS -X POST https://api.gaffa.dev/v1/browser/requests \
  -H "X-API-Key: ${GAFFA_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://quotes.toscrape.com/js/",
    "proxy_location": "us",
    "async": false,
    "max_cache_age": 0,
    "settings": {
      "time_limit": 60000,
      "actions": [
        { "type": "generate_markdown", "output_type": "inline" }
      ]
    }
  }'
Respuesta (recortada):
{
  "data": {
    "id": "brq_VzUDkVAjxNNBDXmkGKyRWPQMiRujoQ",
    "state": "completed",
    "credit_usage": 2,
    "http_status_code": 200,
    "running_time": "00:00:05.6373027",
    "actions": [
      {
        "type": "generate_markdown",
        "output": "# [Quotes to Scrape](/)\n\n[Login](/login)\n\n“The world as we have created it is a process of our thinking..."
      }
    ]
  }
}
5,6 segundos. 2 créditos. Las citas de esa página solo existen después de que se ejecute JavaScript, y llegaron.
La base funciona. Ahora toma el control el agente.
Paso 4: deja que Claude Code construya una automatización real
Elegí a propósito una tarea incómoda.
La página de búsqueda quotes.toscrape.com/search.aspx tiene dos desplegables: autor y etiqueta. Parece sencillo. No lo es. El desplegable de etiquetas está vacío hasta que eliges un autor, porque lo rellena un postback de ASP.NET de los de toda la vida.
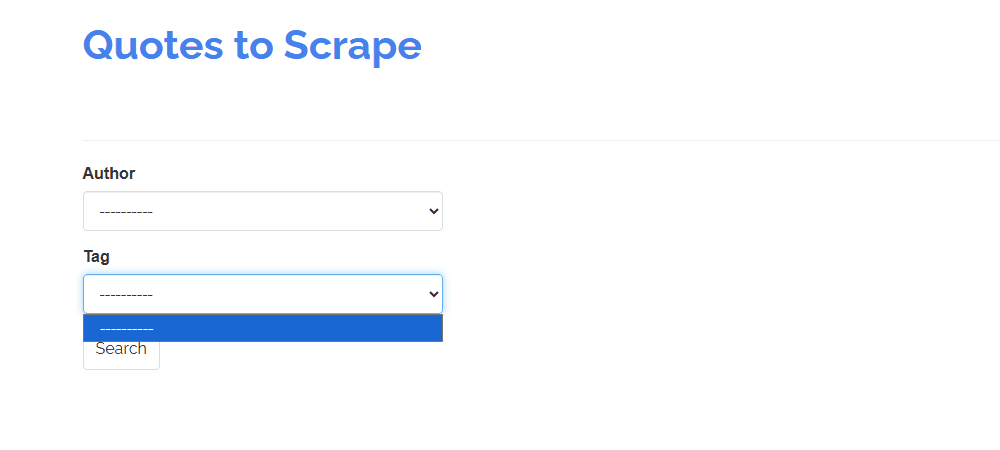
El desplegable Tag antes de elegir autor. Captura hecha con capture_screenshot de Gaffa.
Un agente a ciegas escribiría elegir autor → elegir etiqueta → clic y fallaría.
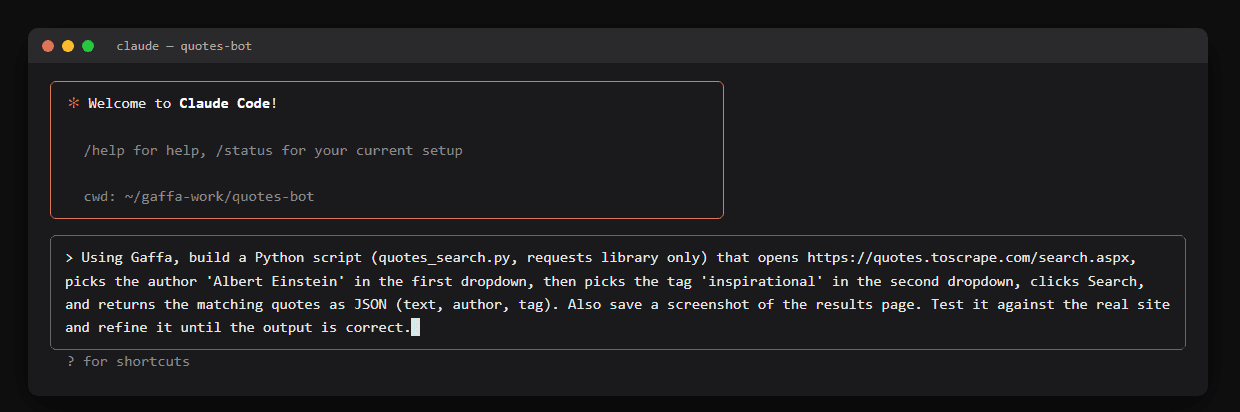
Este es el prompt exacto que le di a Claude Code dentro de la carpeta quotes-bot:
Using Gaffa, build a Python script (quotes_search.py, requests library only)
that opens https://quotes.toscrape.com/search.aspx, picks the author
'Albert Einstein' in the first dropdown, then picks the tag 'inspirational'
in the second dropdown, clicks Search, and returns the matching quotes as
JSON (text, author, tag). Also save a screenshot of the results page.
Test it against the real site and refine it until the output is correct.
Sin selectores. Sin pistas sobre el postback. Solo el objetivo.
Lo primero que hizo Claude: reconocimiento, no código
Claude cargó la skill gaffa-authoring por su cuenta. Primero intentó usar el servidor MCP de la documentación de Gaffa, pero yo aún no lo había aprobado, así que pasó a leer las páginas de la documentación directamente (la skill trae ese plan B incorporado). Después leyó la referencia de acciones que viene con la skill.
Un detalle que me gustó: comprobó que GAFFA_API_KEY estaba definida imprimiendo solo su longitud. Nunca el valor.
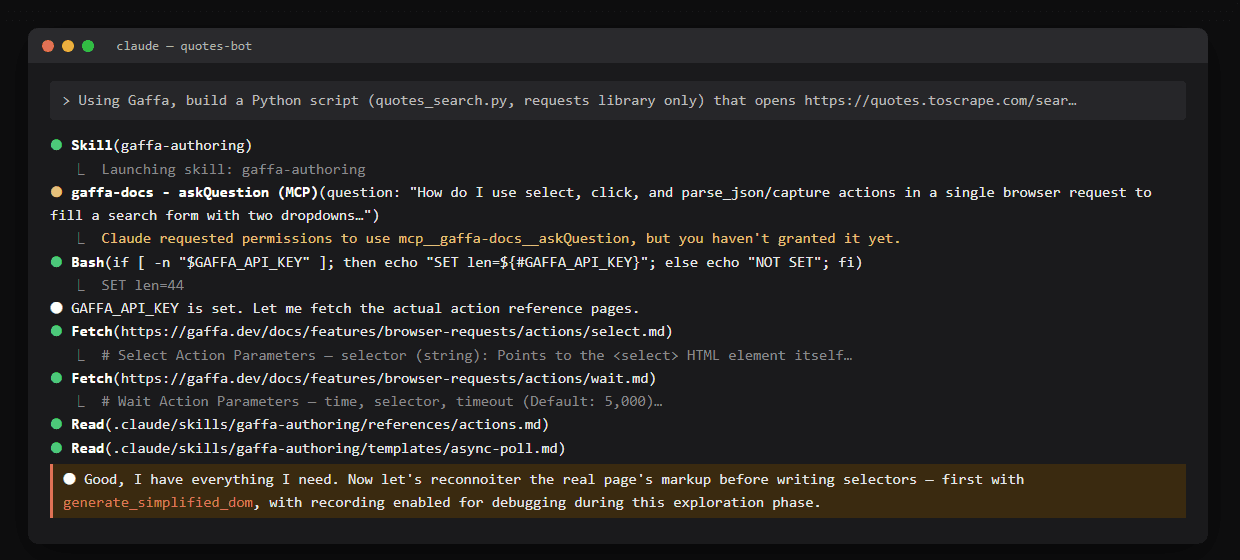
Reconstruida a partir de la transcripción real de la sesión.
Luego, en lugar de escribir el script, envió una petición a Gaffa con generate_simplified_dom para mirar la página real.
El primer intento falló. Claude había añadido output_type: "inline", que esa acción no acepta, y la API respondió con un error claro, invalid_action_param. Claude quitó el parámetro y lo volvió a intentar. 3 créditos después, tenía el DOM de la página.
Ahí fue donde detectó la trampa. En sus propias palabras:
"The tag dropdown is empty until an author is selected (ASP.NET postback via
__doPostBack). I need to see what tag options populate after selecting Einstein before writing the script."
Envió una segunda petición (elegir el autor y después capturar el DOM) para ver aparecer las opciones de etiqueta. Y una tercera con el flujo completo y una captura de pantalla, que abrió y revisó.
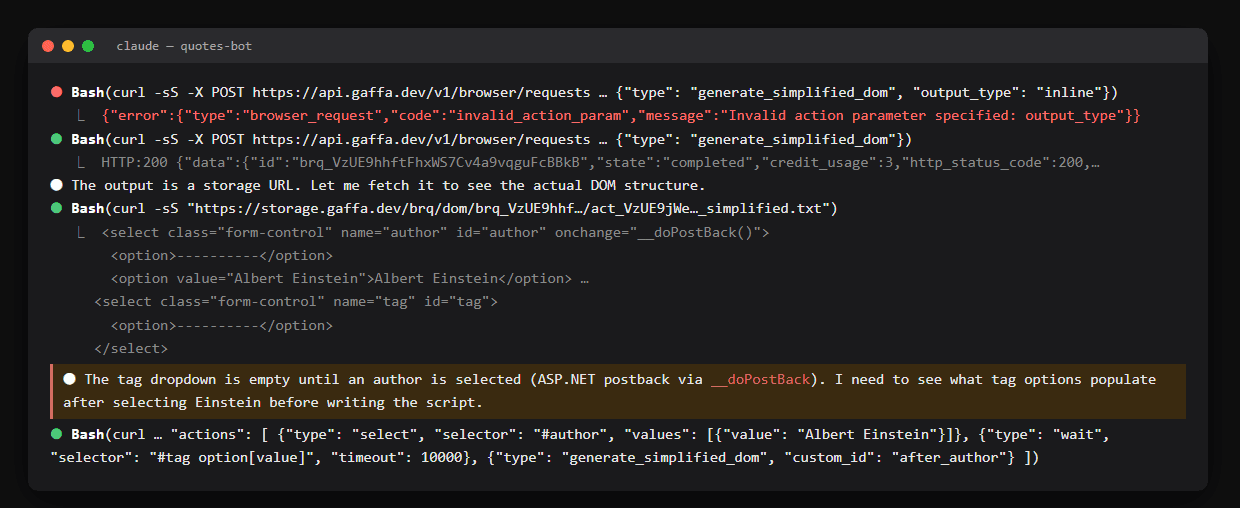
Reconstruida a partir de la transcripción real de la sesión: la primera petición fallida, el DOM con el select #tag vacío y el momento en que Claude detecta __doPostBack.
Solo después de eso escribió quotes_search.py.
Este es el comportamiento que impone la skill: no adivines el HTML de la página, captúralo primero.
Probar y pulir
Con la petición ya validada, Claude escribió quotes_search.py y lo fue ejecutando contra la web real, corrigiendo pequeños detalles por el camino, hasta que devolvió la cita correcta.
Después intentó romper su propio script. Repitió el caso por defecto y probó por su cuenta otras combinaciones de autor y etiqueta. Una de las pruebas usaba una etiqueta que no existe para ese autor. El select falló y las acciones siguientes volvieron como action_cancelled. Claude identificó bien que era un dato de prueba incorrecto y no un fallo del script, consultó la lista real de etiquetas de ese autor con una petición más a Gaffa y volvió a probar con una combinación válida.
Luego limpió sus archivos de prueba.
Sin copiar y pegar errores. Sin "así es como se ve la página". Yo solo leí el resumen final.
La petición resultante
El núcleo del script final es esta lista de acciones:
body = {
    "url": "https://quotes.toscrape.com/search.aspx",
    "proxy_location": "us",
    "async": True,
    "max_cache_age": 0,
    "settings": {
        "time_limit": 45_000,
        "actions": [
            {"type": "select", "selector": "#author", "values": [{"value": author}]},
            # The author's onchange triggers an ASP.NET postback that repopulates
            # the (initially empty) tag dropdown, so wait for it before selecting.
            {"type": "wait", "selector": "#tag option[value]", "timeout": 10_000},
            {"type": "select", "selector": "#tag", "values": [{"value": tag}]},
            {"type": "click", "selector": "input[name='submit_button']"},
            {
                "type": "wait",
                "selector": ".results .quote",
                "timeout": 10_000,
                "continue_on_fail": True,  # a genuine zero-result search has no .quote
            },
            {"type": "capture_dom", "custom_id": "results_dom"},
            {"type": "capture_screenshot", "size": "fullscreen", "custom_id": "results_screenshot"},
        ],
    },
}
Ese wait sobre #tag option[value] es la línea que un agente a ciegas nunca escribe. Existe porque Claude miró la página.
El resto del script envía la petición en modo asíncrono, consulta GET /v1/browser/requests/{id} hasta que state vale completed, descarga el DOM y la captura, y extrae las citas con expresiones regulares. Y en todo momento lee la clave solo de GAFFA_API_KEY.
El resultado
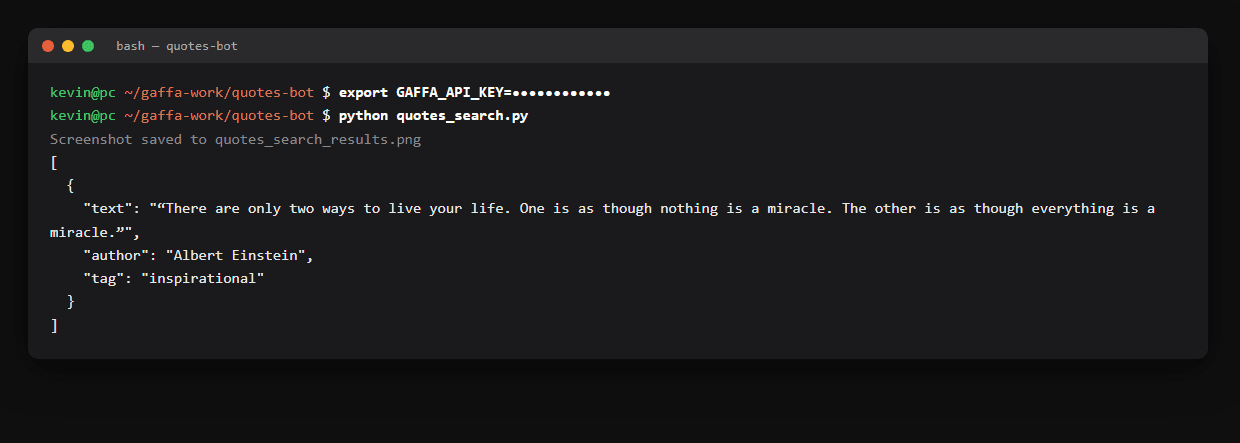
Ejecuté yo mismo el script final, en una terminal nueva:
python quotes_search.py
[
  {
    "text": "“There are only two ways to live your life. One is as though nothing is a miracle. The other is as though everything is a miracle.”",
    "author": "Albert Einstein",
    "tag": "inspirational"
  }
]
Y esta es la captura que hizo Gaffa de la página de resultados:
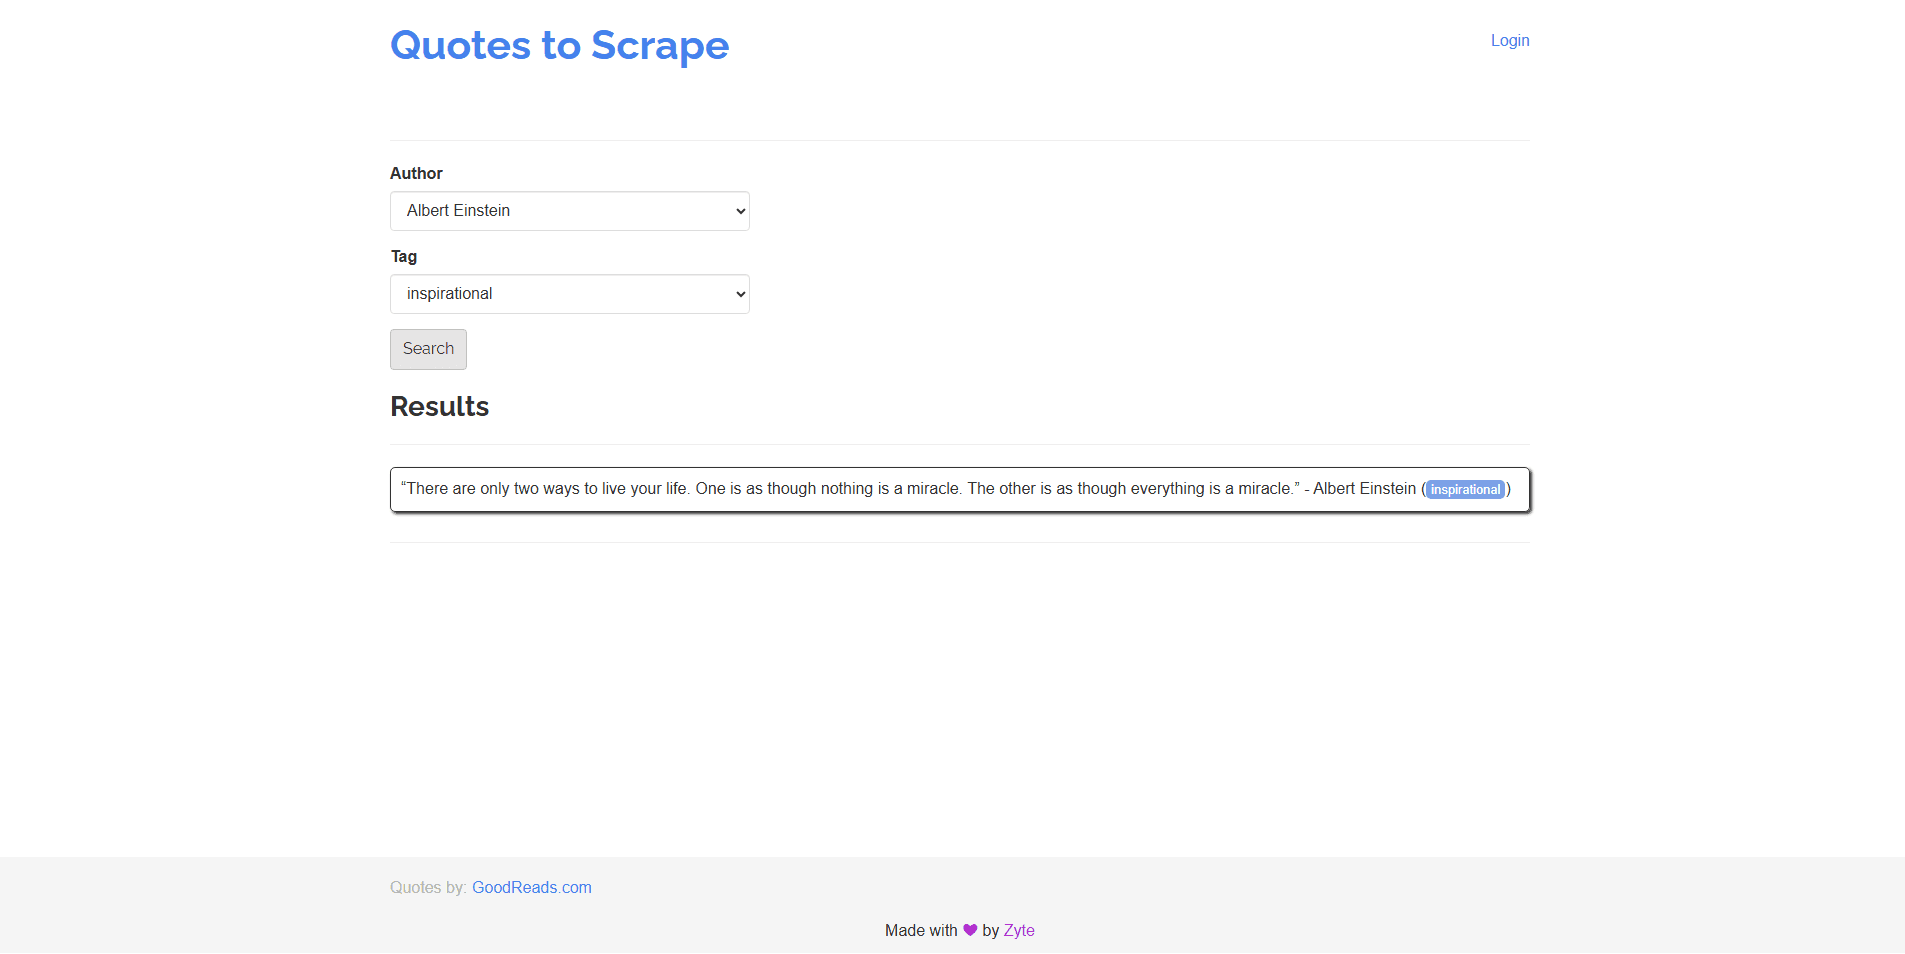
Los dos desplegables están rellenos, la búsqueda se ejecutó y aparece la única cita que coincide.
Lo que costó
Datos reales del historial de peticiones (GET /v1/browser/requests) de todo lo que ejecutó Claude: reconocimiento, iteraciones y validación:
| Métrica | Valor |
|---|---|
| Peticiones a Gaffa (cobradas) | 10 |
| Créditos usados | 23 |
| Créditos por petición | De 2 a 3 |
| Tiempo por petición | De 4 a 10 segundos |
| Sesión de Claude Code | ~7 minutos |
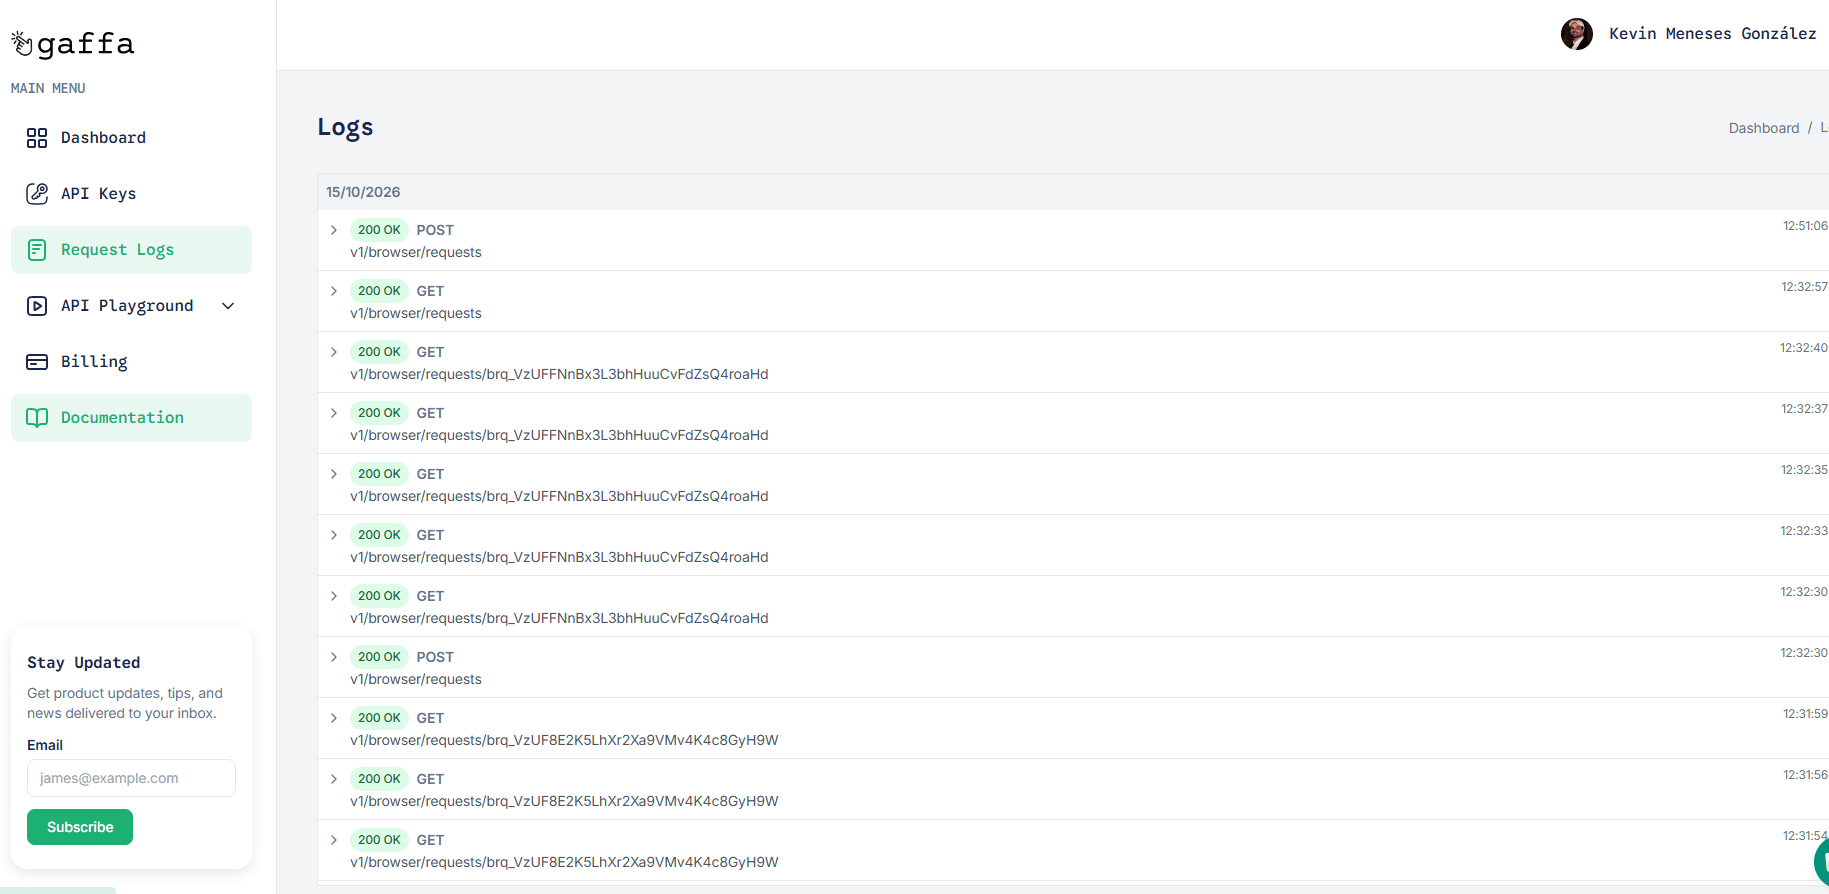
Request Logs en el panel de Gaffa: cada POST que lanzó una petición de navegador y cada GET que consultó su resultado.
La petición rechazada con invalid_action_param nunca llegó a ejecutarse, así que no costó nada. Gaffa cobra 1 crédito por cada 30 segundos de navegador, más el ancho de banda del proxy residencial a 750 créditos por GB, por eso una página ligera cuesta unos 2 créditos con proxy_location activado. La parte de Claude Code funcionó dentro de mi suscripción normal de Claude Pro. Sin factura de API aparte.
Por qué funciona esta configuración
Después de la prueba, me quedé con tres cosas.
Las skills cambian el comportamiento, no solo el conocimiento.
La documentación le dice a un agente qué acepta la API. Las skills le dicen cómo trabajar: capturar antes de seleccionar, fijar time_limit de forma explícita, no dejar la grabación activada en el código final y mantener la clave fuera de los logs. Claude siguió todas esas reglas sin que se lo pidiera.
El navegador cierra el ciclo. Claude detectó el postback, un parámetro de acción no válido y un dato de prueba erróneo porque podía ejecutar una petición y leer la salida real. Esa es la diferencia entre "código que parece correcto" y "código probado".
Todo sigue siendo REST puro.
El resultado es un script de Python normal con requests. Sin SDK propietario y sin atarte a ningún framework. Puedes leerlo, subirlo al repositorio y ejecutarlo en tu CI.
Bonus: las otras skills
La instalación también le dio a Claude otras tres skills que conviene conocer:
/gaffa-find: le das una URL y un objetivo en lenguaje natural ("encuentra el nombre del CEO en esta web"). Itera entre reconocimiento, extracción y validación con un tope de créditos incorporado (50 créditos por ejecución por defecto)./gaffa-debug: le pasas una petición fallida o un idbrq_*y diagnostica el fallo a partir de la grabación de la petición, proponiendo un parche mínimo./gaffa-support: cuando te atascas, intenta resolver el problema y después prepara un informe anonimizado para el equipo de soporte de Gaffa. No gasta créditos.
En el próximo artículo profundizaré en gaffa-find y en un flujo completo de recogida de datos.
Puntos clave
- Un solo comando (
npx @gaffa-dev/cli install) conecta Claude Code con Gaffa: cuatro skills más un servidor MCP de documentación, versionados con tu proyecto.doctorconfirma que todo funciona. - Claude encontró la trampa del postback de ASP.NET capturando la página real antes de escribir un selector, y luego probó su propio script contra la web real sin mi ayuda.
- Una sesión completa de construcción y pruebas costó 23 créditos de Gaffa.
Conclusión
Escribir automatizaciones de navegador nunca fue lo difícil.
Lo difícil era verificarlas.
Dale a tu agente un navegador real y las reglas para usarlo bien, y dejará de adivinar. Empezará a probar.
👉 Pruébalo tú mismo: crea una cuenta en gaffa.dev, ejecuta npx @gaffa-dev/cli install y pásale a Claude Code esa página que llevas tiempo queriendo automatizar.